当我第一次听到“向量数据库”这四个字的时候是抗拒的(已经有 SQL、NoSQL 数据库了),感觉又是个造词的东西。后来自己做一个客服问答的检索,才明白它补的是什么位置。
假设你有一批 FAQ 文档,用户问:“买的东西不想要了,钱能退回来吗?”。
用 MySQL 的 LIKE 或者 ES 的 match 去查,你能匹配上的关键词是“退”,运气好能捞到“退款”那条。但用户说的是“不想要了”、“钱退回来”,字面上跟“如何申请退款”几乎不重叠,传统检索就哑火了。
向量检索换了个思路:
把每段文字压成一串数字(向量/embedding),语义相近的文字,它们压出来的数字串在空间里就挨得近。于是“检索”变成了“在空间里找离你最近的几个点”。上面那个问题,跟“如何申请退款”在语义空间里就应该挨着,哪怕一个字都不重合。
下面假设向量的维度是 2,演示向量检索的用法:
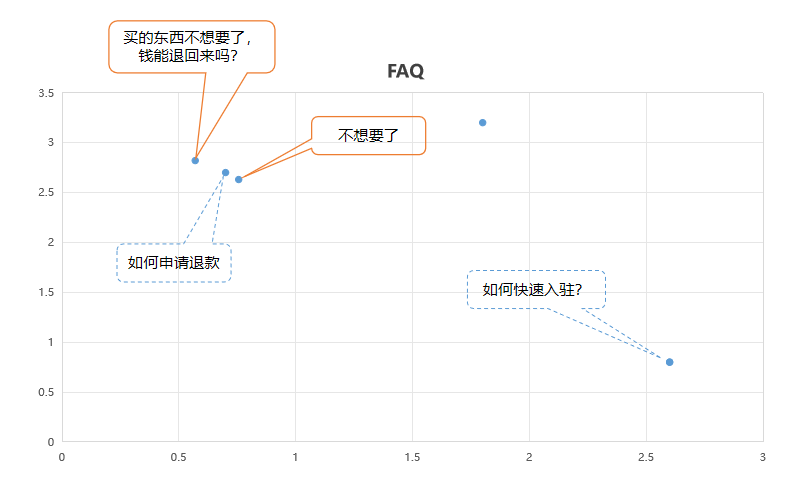
上图中,用户问“买的东西不想要了,钱能退回来吗?”和“不想要了”通过 embedding 生成向量,该向量的位置和“如何申请退款”离得很近,因此就返回“如何申请退款”问题给用户。
注意:选择合适的 embedding 嵌入模型很关键,好的模型可以将语义相关的内容压缩的向量在空间上更近,检索出来的数据才会更准确。
Chroma 干的活就是:
帮你把文字(或图片)变成向量 —— 这步叫 embedding,可以交给它自带的模型,也可以你自己算好塞进去,推荐自己提前算好。
把向量、原文、附加信息(metadata)一起存下来,我们最终目的是要获取原文内容,向量只是用于查找使用,对用户没有意义。
建索引,让你能快速查“跟这句话最像的前 N 条”。
查的时候还能按附加信息做过滤,比如“只要 2024 年之后的”、“只要 category='售后' 的”,也可以理解附加信息就是标签,我们可以通过标签进行过滤。
一句话概括:Chroma 是一个带了存储、过滤和索引的“语义相似度搜索引擎”,专门为给大模型喂上下文(RAG)这类场景设计的。
 川公网安备51010802032098