下面介绍几种安装 Chroma 的方法:
用 pip 安装
如果你想使用 chroma 学习 RAG,或者搭建 RAG 示例应用,推荐使用该种方式,太简单了:
pip install chromadb
执行过程:
装完验证一下:
python -c "import chromadb; print(chromadb.__version__)"
我这边输出:
1.5.9
建议开个虚拟环境
Chroma 依赖不算少(onnxruntime、tokenizers、numpy、pydantic 等),直接往系统 Python 里装容易跟别的项目打架。
# 1.创建虚拟环境
python -m venv .venv

# 2.激活虚拟环境,Windows 用 .venv\Scripts\activate
source .venv/bin/activate

# 3.安装 chromadb,将直接安装到 .venv 虚拟环境中
pip install chromadb
如果你使用的是 uv,安装更快:
# 1. 使用 uv 创建虚拟环境(目录名 venv)
uv venv

# 2. 在虚拟环境中安装 chromadb 向量数据库
uv pip install chromadb
只连服务端的话装精简包
如果你的程序只是连一个已经跑起来的 Chroma 服务,不需要本地计算 embedding,可以装 chromadb-client(类似于数据库的驱动):
pip install chromadb-client
这个包依赖少很多,镜像能小一大截。但注意它不带默认嵌入函数,你要是 add(documents=...) 不传 embeddings,得自己指定 embedding function 并装好对应依赖。生产环境我一般推荐这么做 —— 嵌入模型放在自己服务里算,Chroma 只当存储。
用 Docker 起服务
如果你想将 chromdb 作为单独的服务使用(类似 redis、mysql 服务),推荐使用 Docker 安装,因为安装很简单:
首先,安装 Docker,如果不会可以查看连接 https://www.hxstrive.com/subject/docker.htm。
其次,使用 docker pull 命令拉取镜像,如下:
docker pull chromadb/chroma
下面是镜像拉取日志:
root@localhost:~# docker pull chromadb/chroma
Using default tag: latest
latest: Pulling from chromadb/chroma
342ce2461d56: Pull complete
4f4fb700ef54: Pull complete
3c4c083c1d6b: Pull complete
95ebd62fd043: Pull complete
80c0cfe87a89: Pull complete
Digest: sha256:1e0b73a187a28757c572acba508c46f48c9e8b0acaf5c20e6d95cdedce1acdf6
Status: Downloaded newer image for chromadb/chroma:latest
docker.io/chromadb/chroma:latest


docker run -v ./chroma-data:/data -p 8000:8000 chromadb/chroma
persist_path: "/data"

==========


                (((((((((    (((((####
             ((((((((((((((((((((((#########
           ((((((((((((((((((((((((###########
         ((((((((((((((((((((((((((############
        (((((((((((((((((((((((((((#############
        (((((((((((((((((((((((((((#############
         (((((((((((((((((((((((((##############
         ((((((((((((((((((((((((##############
           (((((((((((((((((((((#############
             ((((((((((((((((##############
                (((((((((    #########

Saving data to: /data
Connect to Chroma at: http://localhost:8000
Getting started guide: https://docs.trychroma.com/docs/overview/getting-started

☁️ To deploy your DB - try Chroma Cloud!
- Sign up: https://trychroma.com/signup
- Copy your data to Cloud: chroma copy --to-cloud --all

No telemetry is configured.
最后,使用 docker run 启动 chroma 数据库服务,如下:
docker run -v ./chroma-data:/data -p 8000:8000 chromadb/chroma
注意:./chroma-data 是数据持久化的位置,容器里固定挂到 /data,如果你不想将数据持久化到本地磁盘,删除容器时数据一起删除,可以不指定 -v ./chroma-data:/data。
1.5 第一个例子
到这里,我们已经万事俱备了。
先跑通一个完整的流程,后面再拆解每个 API,为后续学习打气。
import chromadb

# 1. 起一个内存模式的客户端(进程结束数据就没了,适合练手)
client = chromadb.EphemeralClient()

# 2. 建一个集合(collection),不指定嵌入函数就用默认的
col = client.create_collection("faq")

# 3. 塞几条数据
col.add(
    ids=["q1", "q2", "q3", "q4"],
    documents=[
        "订单付款后多久发货?一般 48 小时内出库",
        "如何申请退款?在订单详情页点击申请退款",
        "发票怎么开?在个人中心-发票管理里申请电子发票",
        "快递丢了怎么办?联系客服补发或全额退款",
    ],
    metadatas=[
        {"category": "物流"},
        {"category": "售后"},
        {"category": "财务"},
        {"category": "售后"},
    ],
)

# 4. 查询数据
res = col.query(query_texts=["怎么申请退款"], n_results=2)
for id_, doc, dist in zip(res["ids"][0], res["documents"][0], res["distances"][0]):
    print(id_, round(dist, 4), doc)
运行示例,输出如下:
q2 0.568 如何申请退款?在订单详情页点击申请退款
q4 0.5751 快递丢了怎么办?联系客服补发或全额退款
再换个说法试试:
res = col.query(query_texts=["买的东西不想要了,钱能退回来吗"], n_results=2)
输出如下:
q1 0.8018 订单付款后多久发货?一般 48 小时内出库
q3 0.9169 发票怎么开?在个人中心-发票管理里申请电子发票
这个结果其实是 “错的”—— 正确答案应该是 q2(退款)。我把这段真实输出贴出来,是想提醒你一件很重要的事:
Chroma 默认的嵌入模型是 all-MiniLM-L6-v2,一个英文小模型。它对中文的语义理解基本等于没有,只能靠字面重叠蒙。上面第一个查询“怎么申请退款”能命中,纯粹是因为字面跟原文高度重合;第二个查询换成口语就彻底废了。
注意了,中文场景一定要换模型,具体怎么换在第 7 章细说。这里先记住结论:默认的那个模型不能直接用。
关于首次运行会下载模型
第一次用到默认嵌入函数时,Chroma 会去下载 ONNX 格式的 all-MiniLM-L6-v2,大概 79 MB,缓存在:
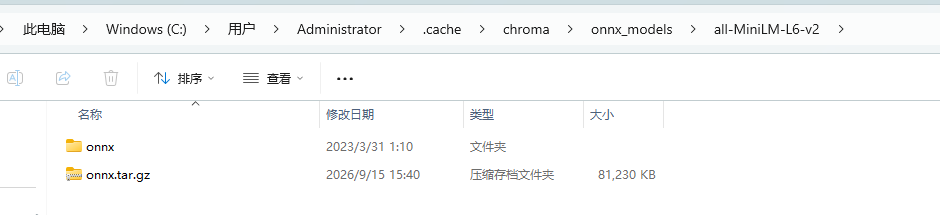
如果下载慢或者不想下载,建集合时传 embedding_function=None 就行(Chroma 不会去下载 all-MiniLM-L6-v2 模型),之后你自己算好向量传进去:
col = client.create_collection("faq", embedding_function=None)
col.add(ids=["a"], embeddings=[[0.1, 0.2, 0.3]])   # 维度自己保证一致
 川公网安备51010802032098