在前面 Record 长什么样子章节,给出了一个 Record,样子如下:
{
 'ids': [['q2']],
 'embeddings': [array([[ 4.05045711e-02,  1.02685414e-01, -8.69980920e-03,
        ...隐藏...
        -9.42492625e-04,  1.17516676e-02,  4.61317971e-02,
         8.79870206e-02,  5.30446088e-03,  4.84681455e-04]])],
 'documents': [['如何申请退款?在订单详情页点击申请退款']],
 'uris': None,
 'included': ['distances', 'documents', 'metadatas', 'embeddings'],
 'data': None,
 'metadatas': [[{'category': '售后'}]],
 'distances': [[0.5679782629013062]]
}
其中,embedding 存储的就是一个 float 数组,这就是对应文本使用 embeddings 模型计算出来的向量值。
向量其实就是一个 float 数组。但是我们还需要了解几个概念:
维度(dimension)
维度指数组的长度。常见的有 384(all-MiniLM-L6-v2)、768、1024(bge-m3)、1536(OpenAI text-embedding-3-small)、3072(text-embedding-3-large)。
注意了,同一个集合里,所有向量的维度必须一致。传错维度会直接报错,例如:
import chromadb

# 获取内存模式客户端
client = chromadb.EphemeralClient()

# 获取集合,如果集合不存在,则创建集合
col = client.get_or_create_collection("demo_col", embedding_function=None)

# 写入数据,维度是3
col.add(ids=["m1"], embeddings=[[1, 0, 0]])

# 写入数据,但是维度是4
col.add(ids=["m2"], embeddings=[[1, 0, 0, 0]])
运行示例,输出如下:
Traceback (most recent call last):
...
chromadb.errors.InvalidArgumentError: Collection expecting embedding with dimension of 3, got 4
这也说明了,维度一旦定下来就改不了,要换模型就得重建集合、重新灌数据。
这是我在项目里最常遇到的“大改”,所以模型选型要在建库之前想清楚,后续修改代价很大。你想象一下,公司所有内部文档都录入到了库中(维度使用 768),后面要调整嵌入模型,改为1536 维度,则需要将公司所有内部文档全部重新调用嵌入模型,重新计算向量,存入数据库。
距离(distance)
Chroma 返回的是“距离”,越小越相似,默认用平方 L2。
L2 平方欧氏距离(默认)
L2 欧氏距离(Euclidean),即平常说的直线距离,公式如下:
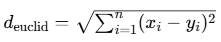
平方欧氏距离(squared L2 /squared Euclidean),不开根号,公式如下:
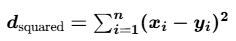
为什么 Chroma 用平方欧氏距离,而不是开根号?
开根号是单调递增函数。比较两个距离大小:
(a < b) 等价于 (sqrt{a}<sqrt{b})
排序结果完全一样!好处是省去大量开平方运算,计算更快,节省 CPU,相似度排序不变。但也有缺点,数值范围变大,不再是直观的“空间直线长度”。
ip 内积
IP(Inner Product,内积),向量内积,也叫点积。
向量:
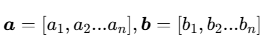
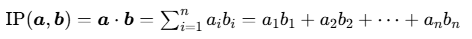
几何定义:
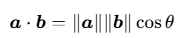
 是两个向量夹角。
cosine 余弦距离
先分清两个极易搞混名词:
余弦相似度(cosine similarity)
余弦相似度,就是看两根箭头朝哪个方向。完全不管箭头长还是短,只看它们的夹角:
箭头几乎指向同一个方向 → 夹角很小 → 余弦相似度高,代表两句话意思很像
箭头互相垂直,90 度 → 完全不沾边,相似度接近 0
箭头朝着相反方向,180 度 → 相似度是负数,意思相反
举个生活化例子:
句子 A:怎么申请退款?
句子 B:我要退货怎么操作?
这两句话语义接近,两根箭头方向差不多,夹角很小 → 余弦相似度很高。
它的箭头和 A、B 方向差很远,夹角大 → 相似度很低。
余弦距离(cosine distance)
想象每个文本都变成一根从原点出发的箭头。
余弦距离,只看两根箭头朝哪个方向,不管箭头长还是短。
两根箭头几乎指向同一个方向 → 夹角很小 → 余弦距离很小,代表两句话意思很像
两根箭头垂直、互不搭边 → 余弦距离中等,意思没啥关系
两根箭头几乎对着反方向 → 夹角很大 → 余弦距离很大,意思完全不一样
两者的根源都是夹角 θ,看的是同一个角度,但他俩是两种不同指标,一个是“相似度分数”,一个是 “距离”,逻辑反过来了,小白很容易混淆。
余弦相似度描述两者有多像,越大越像,是相似分:
夹角越小,分数越高
同向(0°)→ 相似度 = 1(满分,最像)
垂直(90°)→ 相似度 = 0(完全无关)
反向(180°)→ 相似度 = -1(截然相反)
余弦距离 = 1 − 余弦相似度,描述两者差得多远,是距离,越小越像:
夹角越小,距离越小
同向(0°)→ 距离 = 0(没差距)
垂直(90°)→ 距离 = 1
反向(180°)→ 距离 = 2(差距最大)
注意了,Chroma 里的 cosine 是余弦距离(1 - 余弦相似度),所以还是越小越好,范围 0~2。跟我一样被 sklearn 的余弦相似度搞混过的举手。
文本 embedding 场景基本都用 cosine。第 9 章细说。
 川公网安备51010802032098