要看明白 Chroma 在磁盘上到底存了些什么,可以使用 PersistentClient 建个本地持久化库,然后塞点数据,观察目录结构。
例如:
import chromadb

client = chromadb.PersistentClient(path="./chroma_data")
col = client.get_or_create_collection("notes", embedding_function=None)
col.add(ids=["id1", "id2", "id3"],
        embeddings=[[1, 0, 0], [0, 1, 0], [0, 0, 1]],
        documents=["a", "b", "c"])
运行示例,我本机实测后,当前目录下面多了一个 chroma_data 数据,结构如下图:
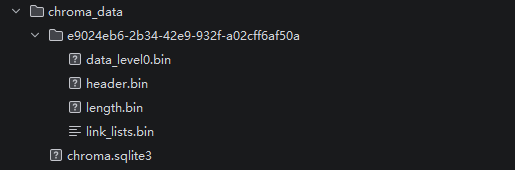
其中:
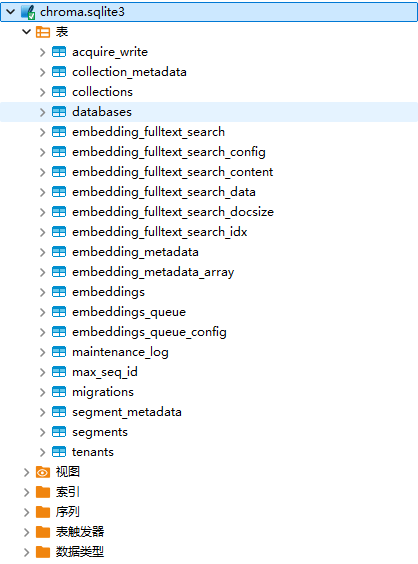
其中:
| 表 | 作用 |
| collections | 集合定义,含 name、dimension、config_json_str,如下图: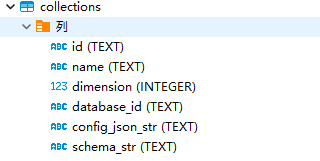 |
| segments | 段(segment)定义,分 VECTOR 段和 METADATA 段 |
| embeddings | 记录 id 到段的映射 |
| embedding_metadataembedding_metadata_array | metadata 的标量值和数组值 |
| embeddings_queue | 写前日志(WAL),还没落进索引的写入 |
| embedding_fulltext_search* | SQLite FTS5 的虚表,给 where_document 用 |
| max_seq_idmigrations | 序列号和迁移记录 |
为什么要了解磁盘存储结构?理解磁盘结构对下面两件事有用:
备份:直接拷整个目录就行,但要在没有写入的时候拷,或者用 chroma vacuum 先整理(第 10 章)。
排查:chroma.sqlite3 可以直接用 sqlite 打开看,查集合配置、查记录数都很方便,比写代码快。
sqlite3 chroma_data/chroma.sqlite3 "SELECT id, name, dimension FROM collections;"
写入什么时候能查到?
Chroma 的写入是“先写日志,再异步建索引”:
add 调用返回时,数据已经进了 SQLite 的 embeddings_queue(WAL)
后台线程把 WAL 里的向量批量刷进 HNSW 索引,刷的时机由 sync_threshold 控制(默认累计 1000 条)
查询时会同时查索引和 WAL,所以不会出现"刚写进去查不到"
所以你不用担心一致性问题,add 返回后立刻 query 一定能查到。
但要知道 WAL 里的数据走的是暴力扫描,WAL 堆太多会拖慢查询 —— 批量灌完数据之后,可以等一会儿或者重启一下让它刷完。
 川公网安备51010802032098