在使用 query 查询数据时,返回结果默认返回了 distances,如下:
{'ids': [['r1', 'r4']],
 'embeddings': None,
 'documents': [['退款流程:在订单页点申请退款,3 个工作日内到账', '退货政策:7 天无理由退货,运费买家承担']], 'uris': None,
 'included': ['metadatas', 'documents', 'distances'], 'data': None,
 'metadatas': [[{'tags': ['退款'], 'cat': '售后', 'year': 2024, 'score': 0.9}, {'year': 2022, 'score': 0.3, 'tags': ['退货'], 'cat': '售后'}]],
 'distances': [[0.60861736536026, 1.050745964050293]]}
distances 实际上是一个距离值,值越小,说明两组向量越相似。具体含义取决于集合配置的 space(默认为 l2):
| space | 距离范围 | 0 表示 |
| l2(平方欧氏) | 0 ~ +∞ | 完全相同 |
| cosine(1-余弦相似度) | 0 ~ 2 | 方向完全一致 |
| ip(1-内积) | -∞ ~ +∞ | 无下界 |
平方欧式换算成相似度
Chroma 默认就是 L2 距离(平方欧式):
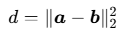
公式特点:d 越小,向量越像;d ≥ 0,没有上限。
但距离不能直接当相似度,需要做映射,把范围压到 [0,1]。通常这样做:
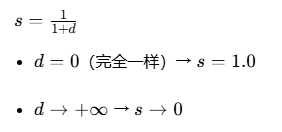
计算出来的 s 就是相似度。例如:
def l2_dist_to_similarity(l2_distance: float) -> float:
    """将L2距离转换为相似度"""
    return 1.0 / (1.0 + l2_distance)

if __name__ == "__main__":
    print(l2_dist_to_similarity(0.2)) # 0.8333333333333334
    print(l2_dist_to_similarity(1.0)) # 0.5
    print(l2_dist_to_similarity(3.0)) # 0.25
除了上面方式,还有指数衰减(适合你自己调陡峭程度):

例如:
import math

def l2_dist_to_similarity_exp(l2_distance: float) -> float:
    """使用指数衰减实现L2转换为相似度"""
    return math.exp(-l2_distance)

if __name__ == "__main__":
    print(l2_dist_to_similarity_exp(0.2)) # 0.8187307530779818
    print(l2_dist_to_similarity_exp(1.0)) # 0.36787944117144233
    print(l2_dist_to_similarity_exp(3.0)) # 0.049787068367863944
余弦距离换算成相似度
用 cosine 时,相似度 = 1 - distance:
dist = res["distances"][0][0]
sim = 1 - dist
print(f"相似度 {sim:.3f}")
如果你不想出现负数,用于展示、打分、阈值判断:
dist = res["distances"][0][0]
sim = (1 - dist) / 2.0 + 0.5
print(f"相似度 {sim:.3f}")
要不要设阈值
经常有人问“距离小于多少算命中?”。我的建议是:别用固定阈值,用相对排序。
原因是不同模型的距离分布差别巨大。同一个问题,用 all-MiniLM 算出来最相似的距离是 0.6,换成 bge-m3 可能就是 0.2。你设的 0.5 阈值换个模型就全废了。
更稳的做法:
import chromadb
from common.custom_embedding import AliQwenEmbeddingFunction

# 自定义嵌入函数实现
ef = AliQwenEmbeddingFunction()

client = chromadb.EphemeralClient()
col = client.get_or_create_collection("demo_col", embedding_function=ef)

# 添加数据自动调用自定义 embedding_function 计算向量
col.add(
    ids=["r1", "r2", "r3", "r4", "r5"],
    documents=[
        "退款流程:在订单页点申请退款,3 个工作日内到账",
        "发票开具:在订单详情页申请电子发票",
        "物流查询:发货后可在物流详情里看到进度",
        "退货政策:7 天无理由退货,运费买家承担",
        "账号安全:如何修改密码和绑定手机",
    ],
    metadatas=[
        {"cat": "售后", "year": 2024, "score": 0.9, "tags": ["退款"]},
        {"cat": "财务", "year": 2023, "score": 0.5, "tags": ["发票"]},
        {"cat": "物流", "year": 2024, "score": 0.7, "tags": ["物流"]},
        {"cat": "售后", "year": 2022, "score": 0.3, "tags": ["退货"]},
        {"cat": "账号", "year": 2024, "score": 0.6, "tags": ["安全"]},
    ],
)

def search_with_gap(res, max_results=5, min_gap_ratio=0.15):
    """取前 K 条,但如果第 1 名和第 2 名差距很大,只返回第 1 名"""
    ids, dists = res["ids"][0], res["distances"][0]
    if not ids:
        return []
    keep = [0]
    for i in range(1, min(len(ids), max_results)):
        # 相对差距:相邻两个结果的距离增幅
        if dists[i - 1] == 0:
            keep.append(i)
            continue
        gap = (dists[i] - dists[i - 1]) / max(abs(dists[i - 1]), 1e-9)
        if gap > min_gap_ratio:
            break
        keep.append(i)
    return [ids[i] for i in keep]

if __name__ == "__main__":
    res = col.query(query_texts=["怎么退款"], n_results=4)
    print(f"ids={res["ids"]}")
    print(f"documents={res["documents"]}")
    print(f"distances={res["distances"]}")
    # 去前2个,最大距离间隔 0.15
    print(search_with_gap(res, max_results=2))
运行代码,输出如下:
ids=[['r1', 'r4', 'r2', 'r3']]
documents=[['退款流程:在订单页点申请退款,3 个工作日内到账', '退货政策:7 天无理由退货,运费买家承担',
    '发票开具:在订单详情页申请电子发票', '物流查询:发货后可在物流详情里看到进度']]
distances=[[0.6035566329956055, 1.045896053314209, 1.247192621231079, 1.3310630321502686]]
['r1']
注意,真正需要阈值的时候(比如“低于多少就不召回”),做法是在你自己的数据集上跑一批标注样本,看距离分布,再定一个数。而且每次换模型都要重定阈值。
 川公网安备51010802032098