前面学习时常提到嵌套函数,通过 embedding_function 设置。你知道嵌套函数在整个过程/流程中定位和角色吗?
下面通过一个简单生活化例子来介绍它:
首先,我们可以将嵌入函数理解为一个翻译员,把文字翻译成一串数字(向量)。Chroma 则是一个会 “按意思找东西” 的记忆笔记本(意思是通过向量距离、相似度来表达,越相似两则越像)。
重点注意:必须使用同一个翻译员,换一个翻译员,翻译出来的东西不一样,也就找不到了。
场景例子
准备工作
我们准备两条小文本,存进 Chroma:
文本 A:小猫爱吃鱼
文本 B:小狗爱吃骨头
第一步:入库
把内容放进 Chroma,对应流程如下:
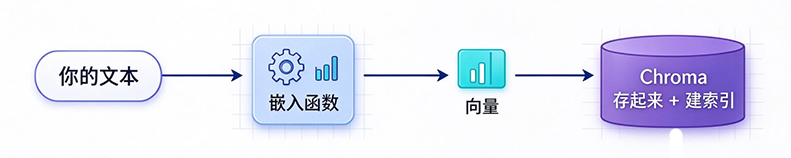
上图中,嵌入函数的职责是将输入的文本翻译成向量。
拿出翻译员(嵌入函数),把文字 “小猫爱吃鱼” 翻译成一串数字(向量) 比如翻译成:“[0.12, 0.78, -0.31, 0.55]”(真实会有几百上千个数字,这里简化成 4 个)
同样这个翻译员,翻译 “小狗爱吃骨头” → “[0.81, 0.05, -0.22, 0.40]”
Chroma 把【原文 + 这串数字】存起来,并且建好索引,方便之后快速查找。
现在 Chroma 里面存了两条记录:
id:A、文字:小猫爱吃鱼、数字向量:[0.12, 0.78, -0.31, 0.55]
id:B、文字:小狗爱吃骨头、数字向量:[0.81, 0.05, -0.22, 0.40]
第二步:提问检索
你来提问,Chroma 从数据库中找出和你提问最相关的数据,对应流程如下:
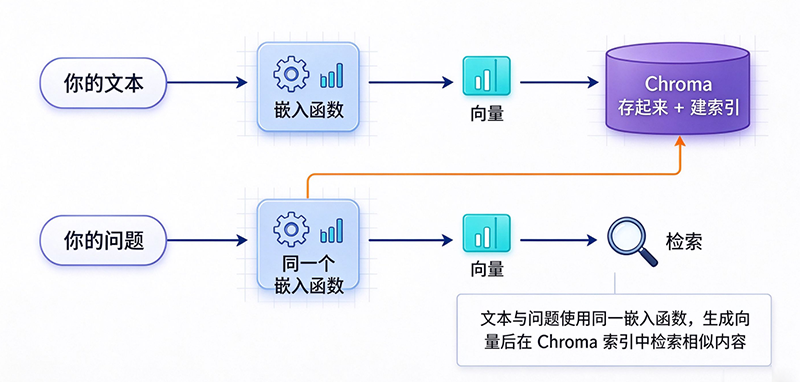
上图中,嵌入函数的职责是将你的问题翻译成向量,需要保证和第一步使用同一个翻译员(向量模型),翻译出的向量才是一样的。
现在你来提问:什么小动物喜欢吃鱼?
还是刚才同一个翻译员! 把这句话翻译成向量:[0.10, 0.75, -0.28, 0.52]
Chroma 拿这个新的数字串,和已经存好的两组数字对比,计算“像不像”(余弦距离)
和「小猫爱吃鱼」的数字非常接近
和「小狗爱吃骨头」差别很大
Chroma 返回结果:“最相似的是:小猫爱吃鱼”
为什么必须同一个嵌入函数?举反面例子
如果换了另一个翻译员,同样一句“什么小动物喜欢吃鱼?”,新翻译员翻译出来是:“[0.99, -0.1, 0.2, -0.7]” 这串数字和之前存的两组数字完全不像,Chroma 就会找不到正确答案!
 川公网安备51010802032098