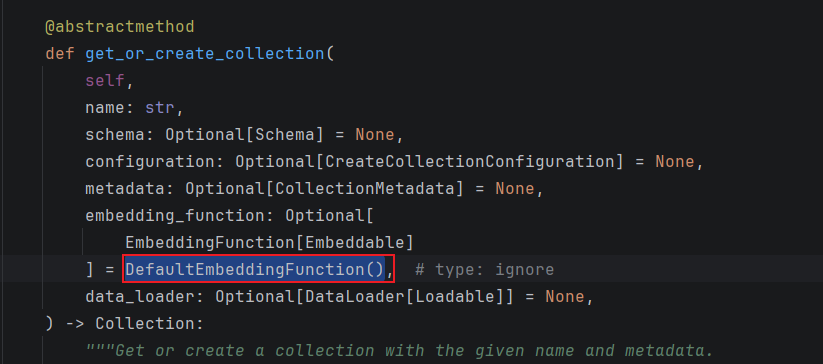
不指定 embedding_function 时,Chroma 用 DefaultEmbeddingFunction,如下图:
DefaultEmbeddingFunction 默认使用 all-MiniLM-L6-v2 模型,如下图:
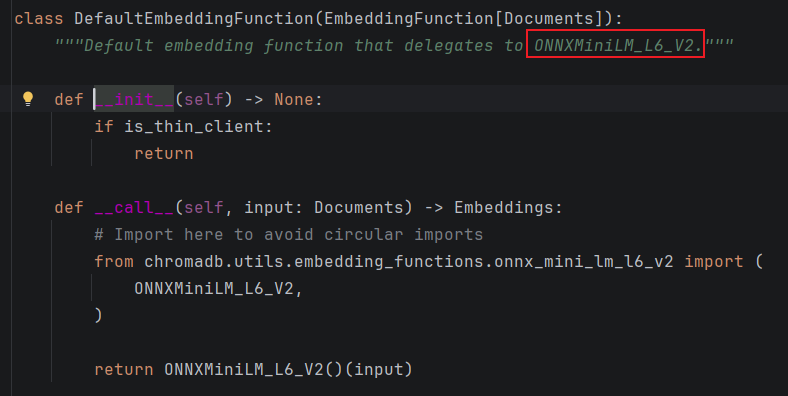
all-MiniLM-L6-v2 模型
模型在 huggingface 中的地址 https://huggingface.co/sentence-transformers/all-MiniLM-L6-v2,如下图:
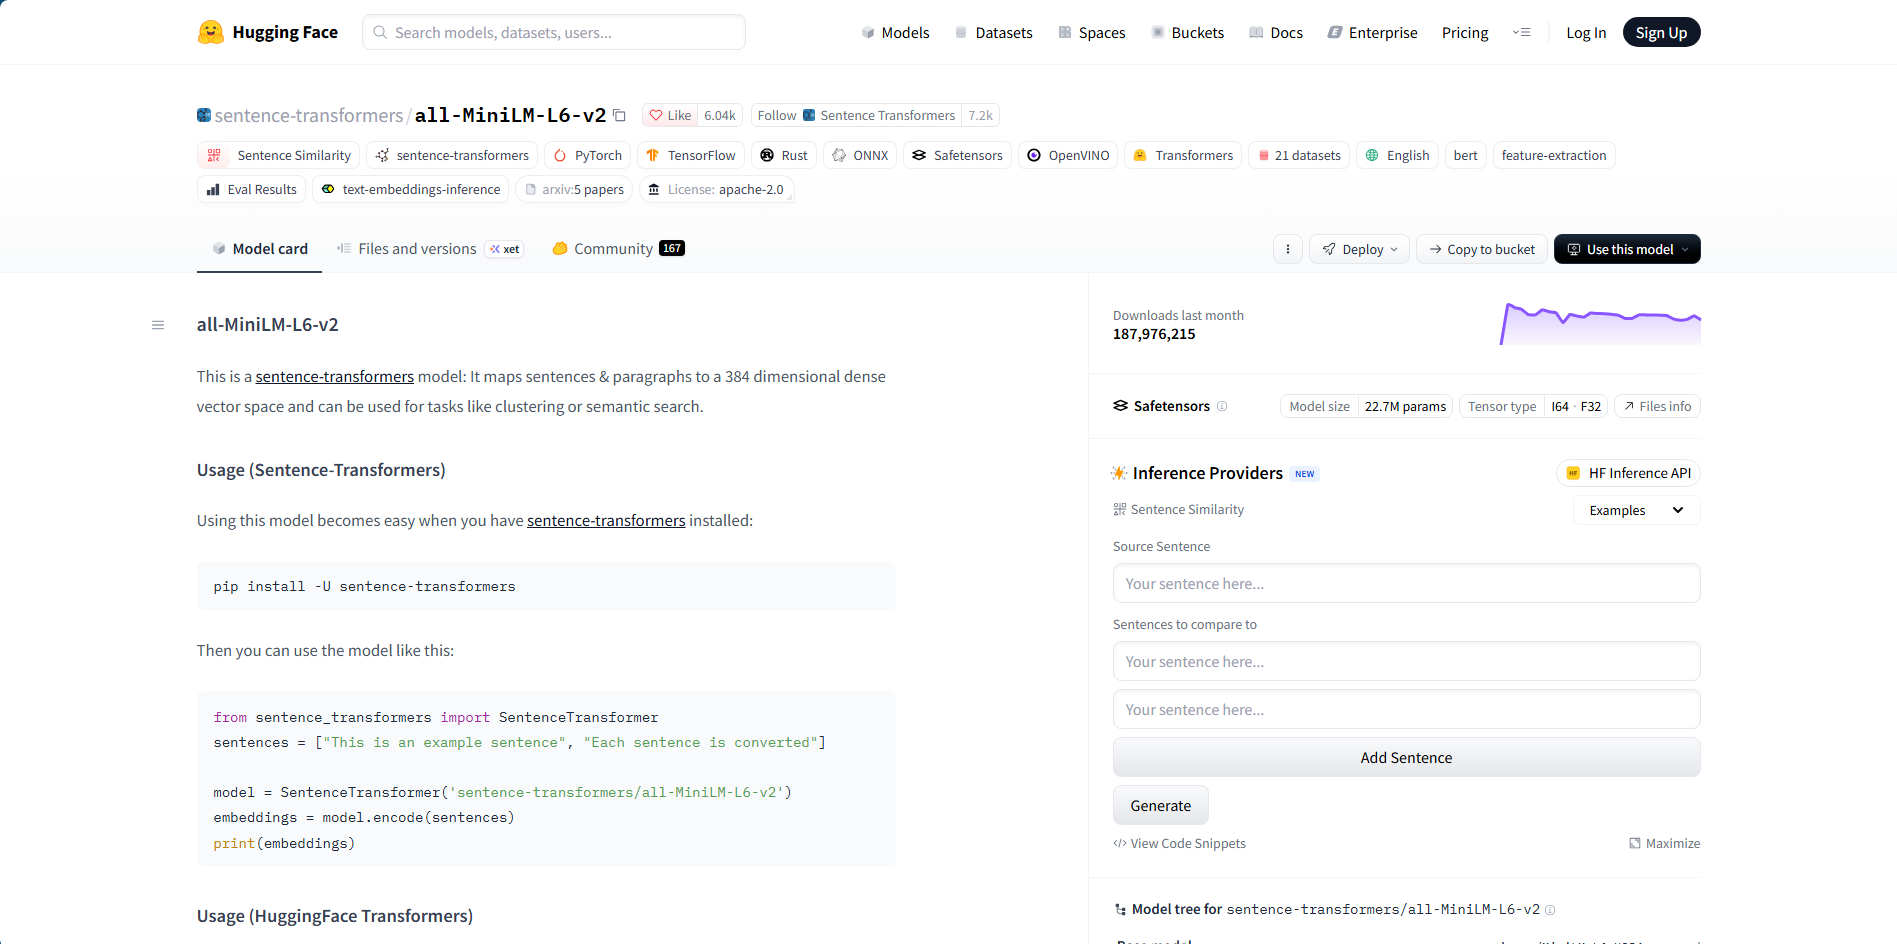
模型基本信息如下:
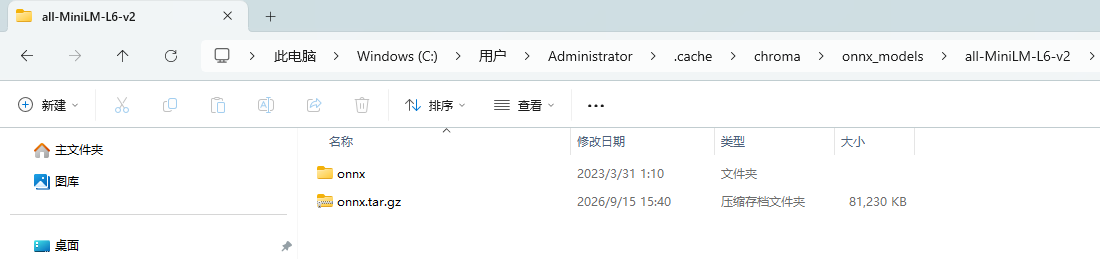
注意,在 Chroma 首次使用模型时,会下载 ONNX 包(约 79 MB)到 “~/.cache/chroma/onnx_models/”地址,如下图:
简单使用 DefaultEmbeddingFunction 类,如下:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction

ef = DefaultEmbeddingFunction()
vecs = ef(["hello", "world"])
print(len(vecs[0]))     # 384
print(type(vecs[0][0])) # <class 'numpy.float32'>
注意了,中文场景不要用默认的,因为该模型对中文支持效果非常差。
嵌入函数简单理解
嵌入函数(Embedding Model / 嵌入模型)本质就是一个训练好的神经网络,它学会了一条规则:意思相近的句子,输出的数字向量挨得近;意思完全不同的句子,向量离得远。
你平时直接调用的 qwen3.7-text-embedding-flash、text-embedding-ada-002 就是成品嵌入函数。
注意:
如果你要训练一个自己的嵌入函数,主要步骤如下:
第 1 步:确定模型底座(选神经网络骨架)
现在绝大多数文本嵌入模型,都是基于 Transformer(BERT 类),没有谁从头手写神经网络底层。
底座相当于一个已经会认字、懂人话的学生;我们再专门给他补课,教会他怎么把一句话浓缩成一串数字用来对比意思。
第 2 步:准备特殊训练数据集(最核心)
使用普通问答数据作为数据集是不行的,嵌入模型需要三元组数据(Triplet),这是训练的灵魂: 一条样本 = (锚文本anchor, 正样本positive, 负样本negative)
训练目标规则(给神经网络定目标):
锚句 和 正样本 的向量距离,尽可能近
锚句 和 负样本 的向量距离,尽可能远
成千上万、几百万条这样的三元组喂给神经网络。
第 3 步:定义损失函数(告诉网络:你错在哪)
损失函数 = 打分器,用来告诉神经网络这次输出好不好,网络根据这个分数修改自己内部的亿万参数。
嵌入最经典:Triplet Loss(三元组损失)
公式通俗理解: 损失 = max( 锚-正距离 − 锚-负距离 + 安全间隔margin , 0 )
目标:让“锚-负距离”至少比“锚-正距离”大一个固定间隔。
举上面例子:
小猫爱吃鱼 ↔ 猫咪喜欢吃鱼 距离:0.05
小猫爱吃鱼 ↔ 高铁跑得很快 距离:1.2
如果差距足够大 → 损失很小,网络表现合格。如果反过来,距离颠倒了 → 损失很大,网络就要修改内部权重。
神经网络内部是几千万个可以调整的小数(参数),训练就是反复微调这些数字,不断降低损失。
第 4 步:训练循环(GPU 反复迭代学习)
流程循环上万轮:
取一批三元组文本,先分词(转成模型认识的 token 编号)
扔进 Transformer 网络,网络自动输出 3 组向量
计算 Triplet Loss 损失
反向传播:自动计算梯度,用优化器(AdamW)修改网络里面所有参数
换下一批数据,重复
这个阶段必须 GPU,比如 A10、A100;一个中文小嵌入模型,在百万数据集上训练,往往要跑几小时~几天。
第 5 步:评估,看模型到底好不好
训练完不能直接用!要在标准评测集上跑分,中文常用 C-MTEB,英文 MTEB。 测什么?
STS 任务:给两句话,模型判断语义相似度,和人类打分对比
检索任务:知识库检索,看能不能召回正确文档(就是你 Chroma 干的事情!)
分类任务:向量拿去做分类,看准确率
如果跑分很差:
第 6 步:导出、封装成 “嵌入函数” 给别人调用
训练收敛、评估达标之后:
把神经网络权重保存下来(比如 pytorch bin、safetensors 格式)
写推理代码:输入文本 → tokenizer 分词 → 模型前向计算 → 输出向量
封装成 API / HuggingFace 格式,别人一行代码调用:
from sentence_transformers import SentenceTransformer
model = SentenceTransformer("bge-small-zh-v1.5")
vec = model.encode("小猫爱吃鱼")
这就是你平时用的嵌入函数。
 川公网安备51010802032098