如果你不想使用本地模型,或者是电脑配置太低,跑不起来。可以使用远程 API 调用模型,如 OpenAI 的 text-embedding-3-small 模型。
它是 OpenAI 第三代轻量嵌入模型,RAG 最常用的云端向量模型之一,替代老的 text-embedding-ada-002。
模型信息如下:
最大上下文:8192 token,超过会自动截断
默认维度:1536,支持 MRL 嵌套表示,可以通过 dimensions 参数降维(256~1536 之间),降低存储开销,损失少量召回精度。
输出向量:默认已经 L2 归一化,所以 Chroma 配置 hnsw:space=cosine 完全匹配(余弦、点积排序结果一致)OpenAI。
价格:$0.02 / 百万 token,非常便宜,远便宜于 text-embedding-3-large。
优势:多语言(中文表现比 ada-002 提升明显)、速度快、成本低、支持降维;
缺点:依赖外网 / 中转 API,有网络延迟、额度、费用问题
下面通过一个示例介绍如何使用 OpenAIEmbeddingFunction 嵌入函数。
安装依赖
运行 pip install openai 命令安装 openai 依赖库,如果已经安装了,跳过该步骤。
环境准备
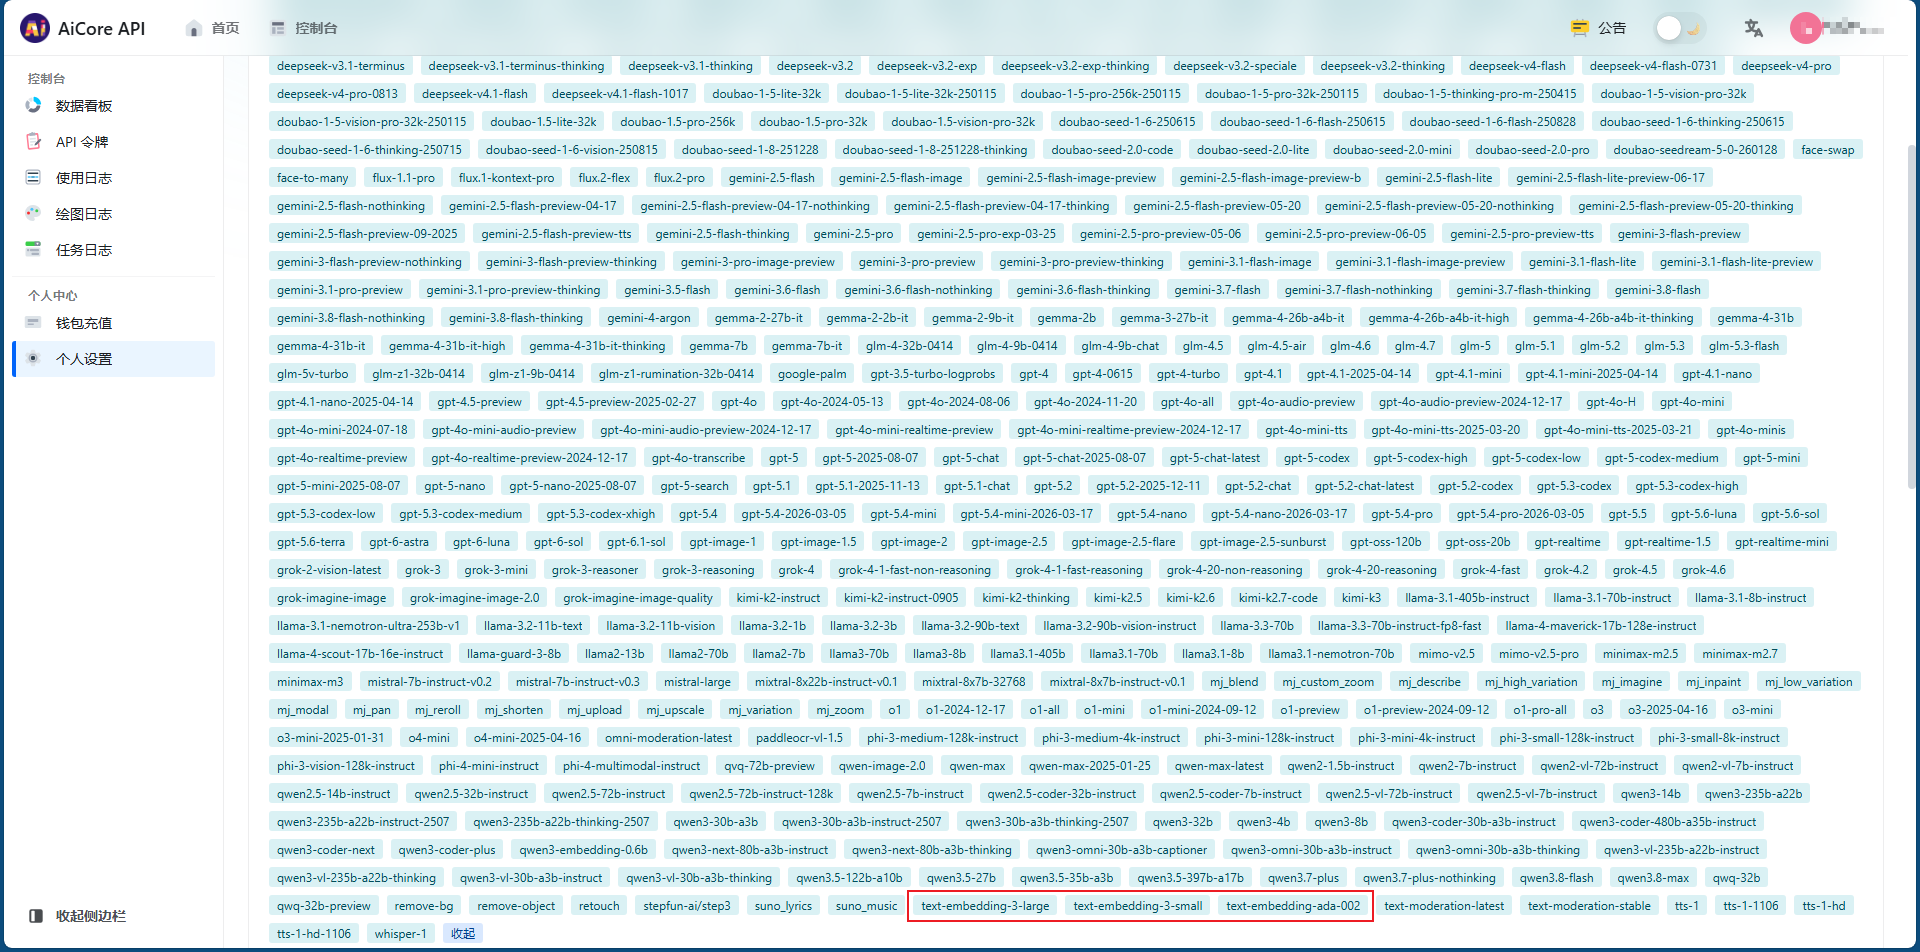
由于国内网络环境无法直接访问 OpenAI,我们需要找一个代理商,这里使用 AiCore API(https://api.xty.app/register?aff=pO2q),主要是一直在使用,你也可以选择其他的代理商。
有很多模型可以使用,如下图:
编写代码
环境准备好后,正式开始编写示例代码:
import os
import chromadb
import tempfile
from chromadb.utils.embedding_functions import OpenAIEmbeddingFunction

# 持久化示例写到临时目录,工作目录保持干净
os.chdir(tempfile.mkdtemp(prefix="chroma_demo_"))

# 创建 OpenAI 远程嵌入函数
# 下面使用 AiCore API 代理商:
# https://api.xty.app/register?aff=pO2q
ef = OpenAIEmbeddingFunction(
    # 替换为代理商的基础地址
    api_base="https://api.xty.app/v1",
    api_key=os.environ["OPENAI_API_KEY"],     # 建议显式传,别依赖默认值
    model_name="text-embedding-3-small",      # 1536 维
    # dimensions=512,                         # 3 系列支持降维,能省不少空间
)

client = chromadb.PersistentClient(path="./chroma_data")
col = client.get_or_create_collection(
    name="kb_zh",
    embedding_function=ef,
    configuration={"hnsw": {"space": "cosine"}},
)
col.add(ids=[
    "a", "b"
], documents=[
    "如何申请退款", "快递丢了怎么办"
])
print(col.query(query_texts=["买的东西不想要了,钱能退回来吗"], n_results=1))
运行代码,输出如下:
{'ids': [['a']], 'embeddings': None, 'documents': [['如何申请退款']], 'uris': None, 'included': ['metadatas', 'documents', 'distances'], 'data': None, 'metadatas': [[None]], 'distances': [[0.3927302360534668]]}
注意:
如果存在 OPENAI_API_KEY 环境变量,Chroma 的 OpenAIEmbeddingFunction 会自动将 api_key 参数设为该环境变量的值。 如果你的 API Key 存放在非标准名称的环境变量里,可以通过设置 api_key_env_var 参数,让这个嵌入函数读取你自定义名称的环境变量。我通常更喜欢显示指定,更易阅读。
text-embedding-3-small 支持 dimensions 参数,利用 Matryoshka 嵌套向量,原生输出 512、256 等低维向量,不是事后压缩。从默认 1536 维降到 512 甚至 256,很多知识库场景召回质量损失很小,但向量体积缩小到原来的 1/3~1/6,内存、存储开销大幅降低,性价比很高。
 川公网安备51010802032098