SentenceTransformer 是一个 Python 库,专门用来快速调用句子嵌入模型,把一句话 / 一段文本变成向量。
它底层就是 PyTorch,封装好了 BGE、all-MiniLM 这类预训练嵌入模型,不用你自己写 Transformer 推理、不用手动处理 token、归一化。
原生 HuggingFace transformers 库虽然能加载 BERT,但 BERT 原生输出不能直接拿来做语义相似度,有一堆坑:
要自己选哪一层输出、选哪个 token(CLS)
自己做池化(mean pooling 平均池化)
自己做向量归一化(算余弦相似度必备)
还要处理 padding、truncate 截断
SentenceTransformer 把上面这一整套固定流程封装好了,一行 .encode() 直接拿到可以丢给 Chroma 的向量。这是我最常用的方式,尤其是中文场景。
下面通过示例介绍它的用法:
(1)安装库
pip install sentence-transformers
(2)示例代码
import chromadb
import os
import tempfile
from chromadb.utils.embedding_functions import SentenceTransformerEmbeddingFunction

# 持久化示例写到临时目录,工作目录保持干净
os.chdir(tempfile.mkdtemp(prefix="chroma_demo_"))

# 使用 SentenceTransformerEmbeddingFunction
ef = SentenceTransformerEmbeddingFunction(
    model_name="BAAI/bge-small-zh-v1.5",   # 中文小模型,512 维
    device="cpu",                          # 有显卡就写 "cuda"
    normalize_embeddings=True,             # 归一化,配合 cosine 用
)

client = chromadb.PersistentClient(path="./chroma_data")
col = client.get_or_create_collection(
    name="kb_zh",
    embedding_function=ef,
    configuration={"hnsw": {"space": "cosine"}},
)
col.add(ids=[
    "a", "b"
], documents=[
    "如何申请退款", "快递丢了怎么办"
])
print(col.query(query_texts=["买的东西不想要了,钱能退回来吗"], n_results=1))
运行代码,输出如下:
...拉取模型,要能访问 huggingface...
Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads.
Loading weights: 100%|██████████| 71/71 [00:00<00:00, 1549.07it/s]
{'ids': [['a']], 'embeddings': None, 'documents': [['如何申请退款']], 'uris': None, 'included': ['metadatas', 'documents', 'distances'], 'data': None, 'metadatas': [[None]], 'distances': [[0.351199746131897]]}
由于我是首次运行,需要下载模型到本地(需要科学上网才行,HuggingFace 访问存在限制),下载后缓存到如下位置:
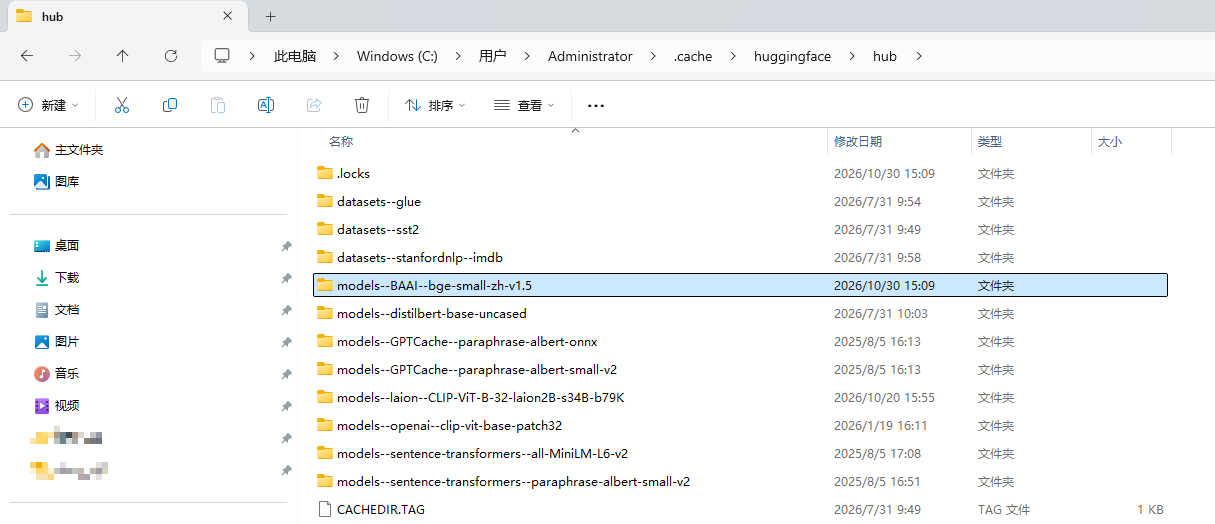
注意,虽然上面运行后缓存了大模型数据,但是再次执行,加载的时候依然会先联网去 Hub 查版本、校验快照元信息(check 更新),不是直接无脑读本地缓存。国内网络无法直连 huggingface.co,不科学上网时这个网络请求超时 / 失败,直接抛出异常。 Chroma 的 SentenceTransformerEmbeddingFunction 包装器默认没有开启 local_files_only。
通常,我们可以提前把模型保存到本地目录,直接加载本地路径。步骤如下:
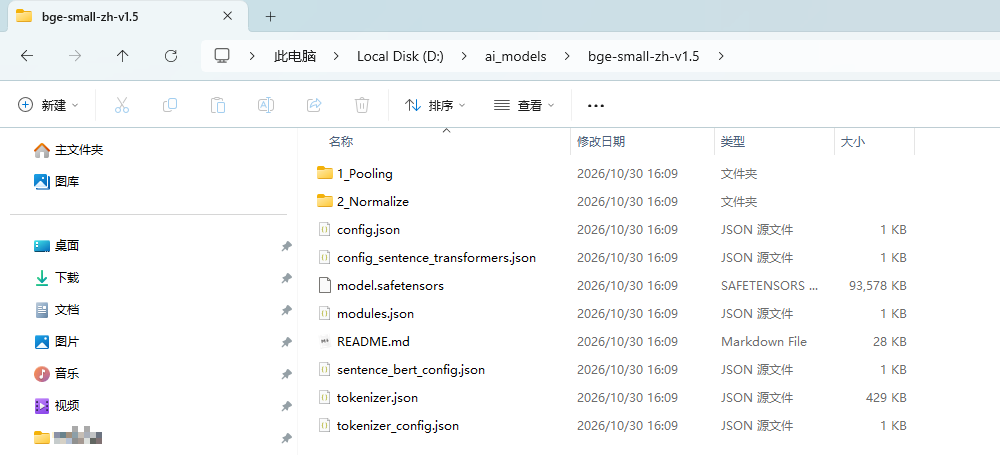
第一步:在科学上网环境执行一次,导出模型到本地文件夹
from sentence_transformers import SentenceTransformer
model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
# 保存全部文件到这个目录
model.save("d:/ai_models/bge-small-zh-v1.5")
执行输出日志:
Loading weights: 100%|██████████| 71/71 [00:00<00:00, 1890.71it/s]
Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads.
Writing model shards: 100%|██████████| 1/1 [00:00<00:00, 19.55it/s]
效果如下图:
第二步:离线环境或没有科学上网,直接加载本地文件夹路径,不再写模型名
import chromadb
import os
import tempfile
from chromadb.utils.embedding_functions import SentenceTransformerEmbeddingFunction

# 持久化示例写到临时目录,工作目录保持干净
os.chdir(tempfile.mkdtemp(prefix="chroma_demo_"))

# 使用 SentenceTransformerEmbeddingFunction
ef = SentenceTransformerEmbeddingFunction(
    model_name="d:/ai_models/bge-small-zh-v1.5", # 从本地加载
    device="cpu",
    normalize_embeddings=True,
)

client = chromadb.PersistentClient(path="./chroma_data")
col = client.get_or_create_collection(
    name="kb_zh",
    embedding_function=ef,
    configuration={"hnsw": {"space": "cosine"}},
)
col.add(ids=[
    "a", "b"
], documents=[
    "如何申请退款", "快递丢了怎么办"
])
print(col.query(query_texts=["买的东西不想要了,钱能退回来吗"], n_results=1))
运行代码,输出日志如下:
Loading weights: 100%|██████████| 71/71 [00:00<00:00, 1529.13it/s]
{'ids': [['a']], 'embeddings': None, 'documents': [['如何申请退款']], 'uris': None, 'included': ['metadatas', 'documents', 'distances'], 'data': None, 'metadatas': [[None]], 'distances': [[0.351199746131897]]}
没有警告信息,而且不需要科学上网,运行速度也很快。
这样做的优点:
中文模型怎么选
踩过不少坑之后,我的清单大概是:
| 模型 | 维度 | 特点 |
| BAAI/bge-small-zh-v1.5 | 512 | 小、快,CPU 能跑,效果够用 |
| BAAI/bge-base-zh-v1.5 | 768 | 效果和速度的平衡点 |
| BAAI/bge-large-zh-v1.5 | 1024 | 效果最好,慢 |
| BAAI/bge-m3 | 1024 | 多语言 + 支持稀疏/多向量,检索比赛常客 |
| shibing624/text2vec-base-chinese | 768 | 老牌中文模型 |
| moka-ai/m3e-base | 768 | 社区常用,中文表现不错 |
bge 系列有个重要细节:官方建议检索时在 query 前面加一段指令前缀,文档侧不加:
import chromadb
import os
import tempfile

# 持久化示例写到临时目录,工作目录保持干净
os.chdir(tempfile.mkdtemp(prefix="chroma_demo_"))

# 查询前缀
QUERY_PREFIX = "为这个句子生成表示以用于检索相关文章:"

# 嵌入函数
class BgeZhEmbedding:
    def __init__(self, model_name="d:/ai_models/bge-small-zh-v1.5"):
        from sentence_transformers import SentenceTransformer
        self.model = SentenceTransformer(model_name)

    def encode_docs(self, texts: list[str]) -> list[list[float]]:
        # 批量编码文档,返回标准list格式给chroma
        emb = self.model.encode(texts, normalize_embeddings=True)
        return emb.tolist()

    def encode_query(self, text: str) -> list[float]:
        # 单条查询编码,加前缀
        emb = self.model.encode([QUERY_PREFIX + text], normalize_embeddings=True)
        return emb[0].tolist()

if __name__ == "__main__":
    bge = BgeZhEmbedding()
    client = chromadb.PersistentClient(path="./chroma_data")
    col = client.get_or_create_collection(
        name="kb_zh",
        embedding_function=None,
        metadata={"hnsw:space": "cosine"}
    )

    docs = ["如何申请退款", "快递丢了怎么办"]
    ids = ["a", "b"]
    embeddings = bge.encode_docs(docs)

    col.add(
        ids=ids,
        embeddings=embeddings,
        documents=docs
    )

    query_str = "买的东西不想要了,钱能退回来吗"
    query_emb = bge.encode_query(query_str)

    # 手动传向量:使用 query_embeddings,不要用 query_texts
    res = col.query(
        query_embeddings=[query_emb],
        n_results=1
    )
    print(res)
运行代码,输出日志如下:
Loading weights: 100%|██████████| 71/71 [00:00<00:00, 2379.93it/s]
{'ids': [['a']], 'embeddings': None, 'documents': [['如何申请退款']], 'uris': None, 'included': ['metadatas', 'documents', 'distances'], 'data': None, 'metadatas': [[None]], 'distances': [[0.40215569734573364]]}
注意,这个前缀能带来几个百分点的提升,别省。
模型下载慢
sentence-transformers 从 HuggingFace 拉模型,国内可以走镜像:
export HF_ENDPOINT=https://hf-mirror.com
Windows PowerShell:
$env:HF_ENDPOINT = "https://hf-mirror.com"
上面命令执行后,仅在当前命令终端生效,关闭后环境变量 HF_ENDPOINT 失效。
推荐在 Python 代码里设置, 放在脚本最最顶部,所有 import 之前,运行代码自动生效,Windows/Mac/Linux 通用:
import os
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"

# 如果需要离线时,取消下面注释
# os.environ["HF_HUB_OFFLINE"] = "1"

# 下面才是导入包
from sentence_transformers import SentenceTransformer
这样做,当把代码发给别人、部署的时候不用“先设置环境变量”,代码自带配置。
注意,不管是通过命令行还是 Python 设置环境变量,底层 huggingface_hub 会拼接下载地址:
如果打开 os.environ["HF_HUB_OFFLINE"] = "1",运行代码会出现如下警告:
Could not reach the Hub (Cannot reach https://hf-mirror.com/api/models/BAAI/bge-small-zh-v1.5: offline mode is enabled. To disable it, please unset the `HF_HUB_OFFLINE` environment variable.). Using cached commit hash for 'BAAI/bge-small-zh-v1.5'.
无法连接 Hub(不能访问 hf-mirror 的接口:因为开启了离线模式。想要关闭离线模式,请删掉 HF_HUB_OFFLINE 环境变量)。将使用本地缓存里记录的 commit 哈希值加载模型。
如果开启 HF_HUB_OFFLINE=1 之后,不会去下载任何东西!它只会读取已经存在本地的缓存。下载动作,必须是关掉离线模式(HF_HUB_OFFLINE 不设置 / 设置为 0)的时候才会发生。
 川公网安备51010802032098