在前面教程大量使用了 PersistentClient 客户端,该客户端是将数据保存到本地磁盘。同时为了不污染测试目录,使用了临时目录,将数据目录放在临时目录,进程退出后,临时目录自动删除。
客户端语法如下:
client = chromadb.PersistentClient(
    path="./chroma_data",              # 数据目录
    settings=None,                     # 可选,Settings 对象
    tenant="default_tenant",
    database="default_database",
)
其中:
path:本地存放向量库文件的文件夹,默认 ./chroma,示例改成了 ./chroma_data
settings:可选,传 Settings 对象,用来配置超时、日志等底层参数
tenant:租户,多租户隔离,默认 default_tenant
database:租户下的数据库,同一租户可以建多个库做隔离,默认 default_database
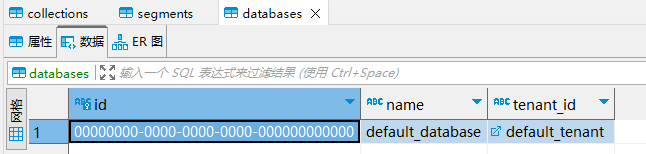
简单一句话:指定本地存储路径,配置租户和数据库,创建本地持久化向量库客户端。
目录结构
跑一遍写入之后,目录长这样(我本机实测):
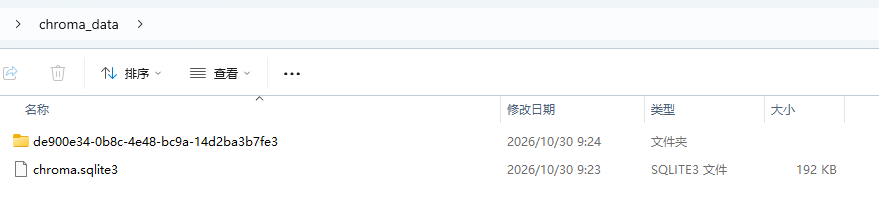
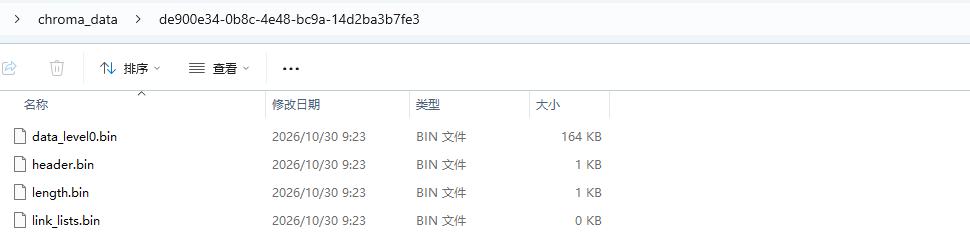
chroma_data/
├── chroma.sqlite3
└── de900e34-0b8c-4e48-bc9a-14d2ba3b7fe3/
    ├── header.bin
    ├── data_level0.bin
    ├── length.bin
    └── link_lists.bin
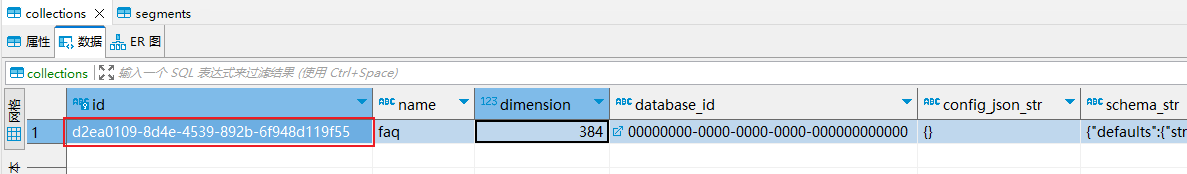
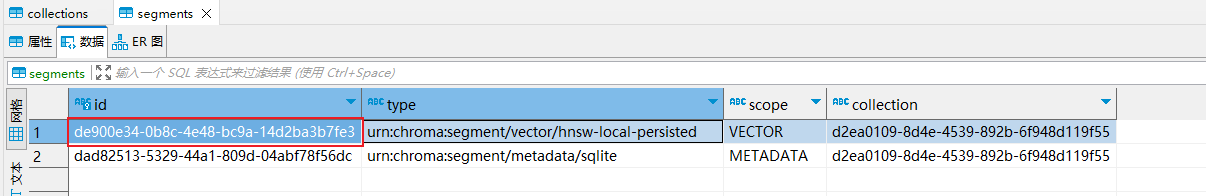
上图两张表的关系如下:
id:分片 UUID(segment_id,就是磁盘目录名)
collection:外键,关联到 collections.id
scope:VECTOR / METADATA / FTS,区分分片类型
type:hnsw 就是向量 HNSW 索引分片
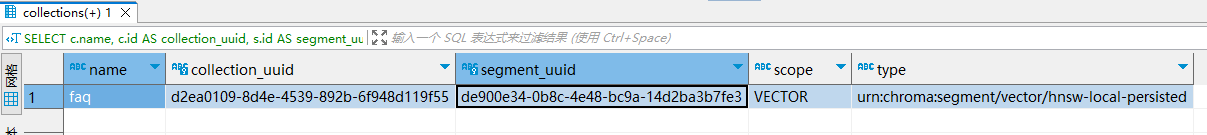
直接在 sqlite3 里执行下面 SQL 语句,查看【集合名称 ↔ 磁盘目录UUID】映射:
SELECT
  c.name,
  c.id AS collection_uuid,
  s.id AS segment_uuid,
  s.scope,
  s.type
FROM segments s
JOIN collections c ON s.collection = c.id
WHERE s.scope = 'VECTOR';
执行结果如下图:
重要限制:不能多进程同时写
PersistentClient 用的 SQLite,同一时刻只允许一个进程持有写锁。两个 Python 进程同时打开同一个目录写数据,会遇到 database is locked 之类的错误。
常见的翻车场景:
解决方案:
开发环境:只用单进程(uvicorn 加 --workers 1)
生产环境:起一个独立的 Chroma 服务,大家都用 HttpClient 连它
实在想多进程读,可以让一个进程写、其他进程只读(SQLite 支持一写多读,但仍不推荐)
我一般的判断标准:只要是 "服务"(长期运行的进程,要被别人访问),就用 HttpClient + 独立服务。PersistentClient 只用在脚本和单进程工具里。
备份
最简单粗暴,但有效的方式是停掉写入,直接拷整个目录:
cp -r chroma_data chroma_data_backup_20260915
想在服务运行中做一致性备份,可以先用 CLI 的 vacuum 把 WAL 整理掉:
chroma vacuum --path ./chroma_data --force --timeout 60
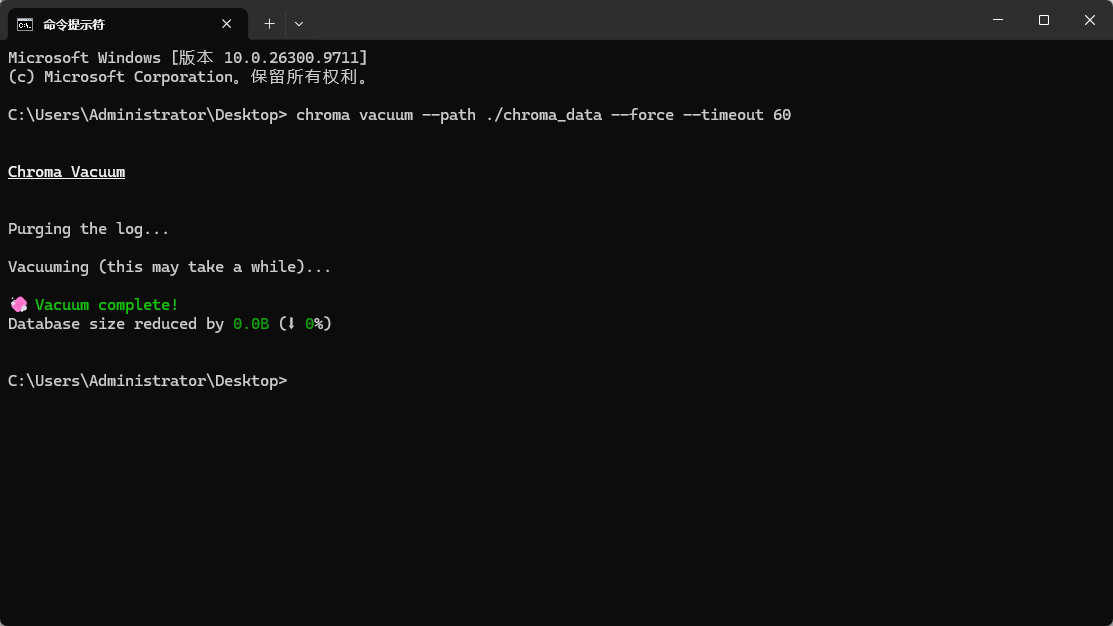
执行完成后,再拷贝。
注意:vacuum 是 Chroma 的清理 / 回收命令,类似数据库 vacuum,清理删除向量、碎片,压缩存储,释放磁盘空间,优化本地持久化库(PersistentClient)。vacuum 会请求独占锁,跑的时候别有别的进程在写。
另外一种方式是只备份 chroma.sqlite3(元数据 + WAL),HNSW 索引可以重建,但重建要时间,除非数据量大否则不划算。
恢复
把备份目录整个拷回去,用 PersistentClient(path=那个目录) 打开就行。没有额外的导入步骤。
例如,加载桌面的 chroma 数据目录
import chromadb

client = chromadb.PersistentClient(
    path="C:/Users/Administrator/Desktop/chroma_data", # 数据目录
    settings=None, # 可选,Settings 对象
    tenant="default_tenant",
    database="default_database",
)
col = client.get_or_create_collection("faq")
for doc in col.get()["documents"] or []:
    print(doc)
运行示例,输出如下:
订单付款后多久发货?一般 48 小时内出库
如何申请退款?在订单详情页点击申请退款
发票怎么开?在个人中心-发票管理里申请电子发票
快递丢了怎么办?联系客服补发或全额退款
 川公网安备51010802032098