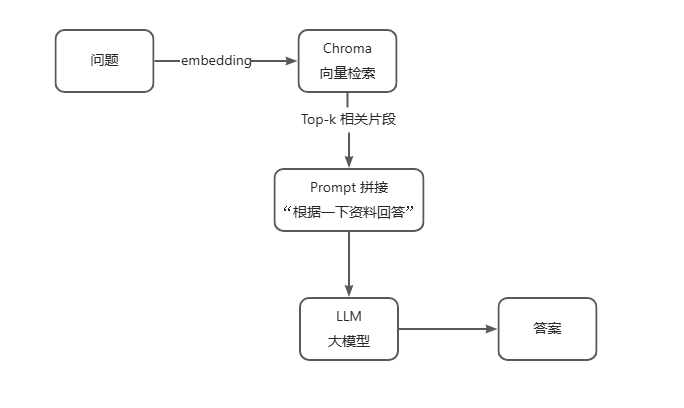
RAG(全称 Retrieval-Augmented Generation,检索增强生成)的核心是:大模型回答问题之前,先去你自己的资料里找一批相关内容,塞进 prompt 里,让它基于这些资料回答。
整个流程如下:
离线部分(灌数据),流程如下:
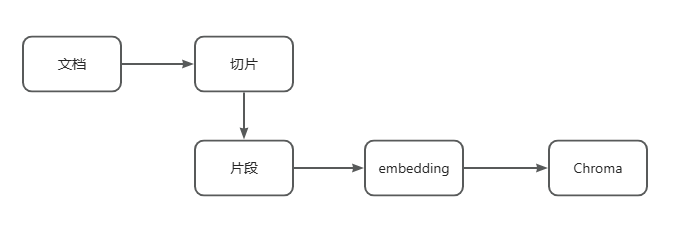
从上图可以看出,Chroma 在 RAG 里面的职责很单纯:存片段、检索片段。至于,切分、embedding、prompt 拼装、调 LLM 都是你的事,需要你自己写代码进行。
为什么需要它?
大模型的知识是训练时固定的,不知道你公司的内部文档,还会一本正经地编(幻觉)。而 RAG 让答案有出处,还能随时更新知识(改库就行,不用重新训练)。
简单例子(前面 FAQ 场景):
知识库里面存了退款、发票、物流文档(就是你之前灌进 chroma 的 faq 集合) 用户问:多久退款?
检索:Chroma 找到「退款流程:订单页申请退款,3 个工作日到账」这条
传给大模型:参考这段资料回答用户
模型输出:申请退款后 3 个工作日内到账
如果没有知识库,当用户问“多久退款?”,大模型会根据训练大模型时的公共知识乱编,然后回复给用户,这种回答就不行,没有参考我们自己的内部文档给出答案。
RAG 优缺点
优点
不用重新训练大模型,新增文档直接入库即可
答案可溯源,降低幻觉
私有数据不会灌进模型训练,数据更安全
缺点
 川公网安备51010802032098