前面章节测试的时候发现一个问题:问 “发票怎么开”,向量检索(bi-encoder)把退款条件、退款流程这些不太相关的片段一起召回了。这种情况业界通用做法是加一层 cross-encoder 重排来优化。
具体流程图如下:
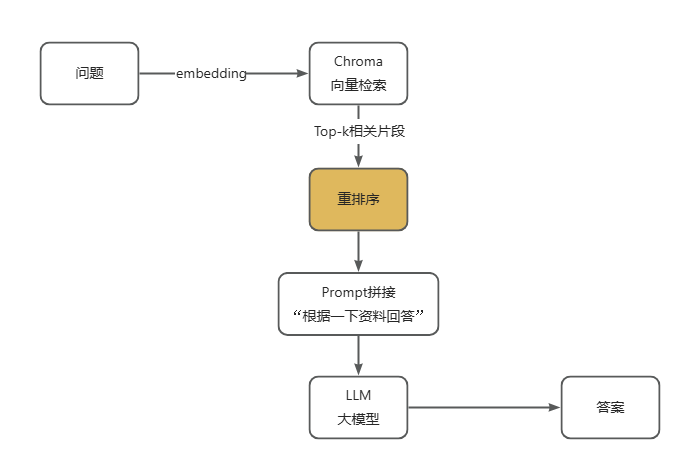
向量检索(bi-encoder)推理快、吞吐高,适合在大量文档里先粗捞一批候选,但它的匹配粒度比较粗,准确度一般。就像这个例子,退款政策切出来的 3 个 chunk 全都被捞出来了,里面混着退款、售后这些无关内容。它算的是整个 chunk 的整体相似度,没办法分辨片段里面哪一小段才是真正和问题有关的。
而重排(cross-encoder)模型不一样,它会把用户问题和候选片段拼在一起输入,做细粒度的语义匹配,可以精准识别 chunk 内部哪些内容和问题是强相关的,匹配效果比 bi-encoder 好很多。缺点是不能提前预生成向量,没法用向量索引加速,每一条候选都要单独跑推理,速度慢、耗算力,直接对全部文档跑重排肯定行不通。
所以现在通用的做法是做成两级检索:先用向量检索粗召回 20~50 条,把候选数量从海量压缩到一小批;再交给重排模型重新打分排序,挑相关性最高的前 5 条,再丢给 LLM 去生成回答。
下面就通过代码来实现这层逻辑:
import os

# 国内直接连 hf 下载容易超时,用国内镜像
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"

class Reranker:
    """重排器"""
    def __init__(self, model_name="BAAI/bge-reranker-base"):
        self.model = CrossEncoder(model_name)

    def rerank(self, query: str, chunks: list[RetrievedChunk], top_k: int = 5):
        if not chunks:
            return []
        pairs = [[query, c.text] for c in chunks]
        scores = self.model.predict(pairs)
        order = sorted(range(len(chunks)), key=lambda i: -scores[i])[:top_k]
        return [(chunks[i], float(scores[i])) for i in order]
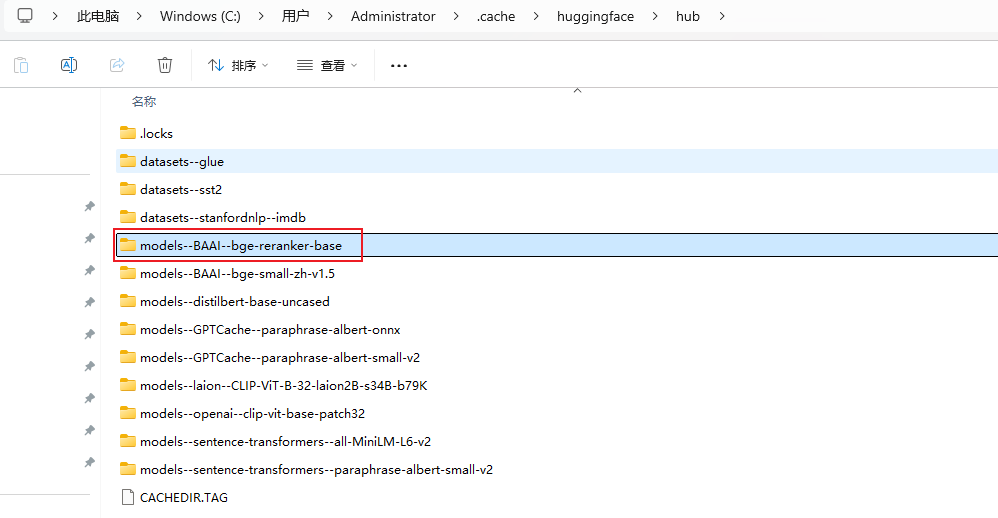
上面代码, 第一次运行时,会从 HuggingFace(已改为从国内镜像)自动下载 BAAI/bge-reranker-base 模型文件,缓存到本地;后续再启动就直接读缓存,不再重复下载。
注意:模型是加载到本机内存 / 显存,所有计算在本地完成。
将 Reranker(重排器)接入到 RAGService 服务中的完整代码如下:
import os

# 国内直接连 hf 下载容易超时,用国内镜像
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"

import tempfile
from chromadb.utils.embedding_functions import OllamaEmbeddingFunction
from demo.prompt_utils import build_prompt
from demo.knowledge import KnowledgeBase
from demo.models import KBConfig, RetrievedChunk
from demo.chunk import split_markdown
from demo.llm import OpenAILLM
from sentence_transformers import CrossEncoder

# 持久化示例写到临时目录,工作目录保持干净
os.chdir(tempfile.mkdtemp(prefix="chroma_demo_"))


class Reranker:
    """重排器"""
    def __init__(self, model_name="BAAI/bge-reranker-base"):
        self.model = CrossEncoder(model_name)

    def rerank(self, query: str, chunks: list[RetrievedChunk], top_k: int = 5):
        if not chunks:
            return []
        pairs = [[query, c.text] for c in chunks]
        scores = self.model.predict(pairs)
        order = sorted(range(len(chunks)), key=lambda i: -scores[i])[:top_k]
        return [(chunks[i], float(scores[i])) for i in order]


class RAGService:
    """知识库问答服务"""
    def __init__(self, kb: KnowledgeBase, llm, top_k: int = 5,
                 min_similarity: float | None = None):
        self.kb = kb
        self.llm = llm
        self.top_k = top_k
        self.min_similarity = min_similarity
        self.reranker = Reranker()

    def answer(self, question: str, where: dict | None = None) -> dict:
        chunks = self.kb.search(question, top_k=self.top_k, where=where)

        print(f"重排前:{[(c.id, c.similarity) for c in chunks]}")
        # 重排【重点】
        chunks = [RetrievedChunk(
            id=rank[0].id,
            text=rank[0].text,
            metadata=rank[0].metadata,
            distance=rank[0].distance,
            similarity=rank[1],
        ) for rank in self.reranker.rerank(question, chunks)]
        print(f"重排后:{[(c.id, c.similarity) for c in chunks]}")

        # 相似度过滤:低于阈值的不喂给模型,省得它瞎编
        if self.min_similarity is not None:
            chunks = [c for c in chunks
                      if c.similarity is None or c.similarity >= self.min_similarity]

        if not chunks:
            return {
                "answer": "资料中没有提到相关内容。",
                "sources": [],
                "has_context": False,
            }

        # 构建提示词
        prompt = build_prompt(question, chunks)
        print(f"prompt:")
        print("=" * 40)
        print(prompt)
        print("=" * 40)

        # LLM对话
        answer = self.llm.complete(prompt)

        return {
            "answer": answer,
            "sources": [
                {"id": c.id, "doc_id": c.metadata.get("doc_id"),
                 "similarity": round(c.similarity, 4) if c.similarity else None,
                 "text": c.text[:200]}
                for c in chunks
            ],
            "has_context": True,
        }


if __name__ == "__main__":
    # 真实环境,用 Ollama 的 bge-m3 模型(先在 ollama 里 pull 并启动服务)
    ef = OllamaEmbeddingFunction(
        url="http://localhost:11434",
        model_name="bge-m3",
        timeout=60,
    )

    # 自定义嵌入函数
    def my_embedding_func(texts: list[str]) -> list[list[float]]:
        return ef(texts)

    # 1) 建知识库:注入配置和嵌入器
    kb = KnowledgeBase(config=KBConfig(), embedder=my_embedding_func)

    # 2) 建服务:使用 AiCore API 代理,注册地址 https://api.xty.app/register?aff=pO2q,有免费额度
    # Ollama 本地跑太慢了
    llm = OpenAILLM(base_url="https://api.xty.app/v1", model="qwen-max")
    rag = RAGService(kb, llm, top_k=3, min_similarity=0.5) # 调整 min_similarity,过滤低相似度chunk

    # 3) 导入一份文档(按 markdown 标题切分)
    doc = """
    # 退款政策

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。

    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。
    """
    chunks = [t for t, _ in split_markdown(doc, chunk_size=150, overlap=30)]
    n = kb.add_document("refund_policy", chunks, meta={"category": "售后", "year": 2026})
    print(f"导入 {n} 个片段,库里共 {kb.count()} 条")

    # 4) 问答
    for q in ["买的东西不想要了,钱能退回来吗", "发票怎么开"]:
        r = rag.answer(q)
        print(f"问题:{q}")
        print(f"回答:{r['answer']}")
        print("来源:")
        for idx, c in enumerate(r["sources"], 1):
            print(f"[{c["id"]}] sim={c["similarity"]} => {c["text"]}")
        print("\n\n")
运行代码,分析输出的内容:
Loading weights: 100%|██████████| 201/201 [00:00<00:00, 875.13it/s]  加载模型
导入 3 个片段,库里共 3 条
重排前:[('refund_policy#1', 0.7277417778968811), ('refund_policy#0', 0.7183234691619873), ('refund_policy#2', 0.6727904081344604)]
重排后:[('refund_policy#0', 0.6817367076873779), ('refund_policy#1', 0.6096324920654297), ('refund_policy#2', 0.37079504132270813)]
prompt:
========================================
你是一个客服助手。请只根据下面提供的资料回答用户的问题。
如果资料里没有相关信息,就明确说"资料中没有提到",不要编造。
回答时请注明你参考了哪条资料(用 [id] 标注)。

资料:
[refund_policy#0] 【退款政策】

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

[refund_policy#1] 【退款政策】
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。


用户问题:买的东西不想要了,钱能退回来吗

回答:
========================================
问题:买的东西不想要了,钱能退回来吗
回答:根据您的情况,如果您购买的商品不是定制类商品、已拆封的音像制品或虚拟商品,并且在签收后7天内未影响二次销售的话,是可以申请无理由退货的。您可以在"我的订单"页面找到对应的订单,点击"申请退款",填写原因并提交。客服会在24小时内进行审核,一旦审核通过,退款将在3-5个工作日内退回到您的原支付账户。[refund_policy#0][refund_policy#1]
来源:
[refund_policy#0] sim=0.6817 => 【退款政策】

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。
[refund_policy#1] sim=0.6096 => 【退款政策】
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。


重排前:[('refund_policy#2', 0.5565662384033203), ('refund_policy#1', 0.46001458168029785), ('refund_policy#0', 0.4485142230987549)]
重排后:[('refund_policy#2', 0.696745753288269), ('refund_policy#1', 0.0002409344306215644), ('refund_policy#0', 0.00015600734332110733)]
prompt:
========================================
你是一个客服助手。请只根据下面提供的资料回答用户的问题。
如果资料里没有相关信息,就明确说"资料中没有提到",不要编造。
回答时请注明你参考了哪条资料(用 [id] 标注)。

资料:
[refund_policy#2] 【退款政策】
内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。


用户问题:发票怎么开

回答:
========================================
问题:发票怎么开
回答:您可以在"个人中心-发票管理"里自助开具电子发票,开票后24小时内会发送到您的预留邮箱。[refund_policy#2]
来源:
[refund_policy#2] sim=0.6967 => 【退款政策】
内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。
分析输出日志,第一个问题检索的 chunk 重排后,两个分片 sim 为 0.6,另一个为 0.3。第二个文件只有一个 chunk 为 0.6,另外两个为 0.0,同时我们也将 min_similarity 调整为了 0.5,最终第一个问题引用了两个 chunk,第二个问题引用了一个 chunk,符合我们的预期。
注意,首次运行,需要耗费更多的时间,因为需要下载 BAAI/bge-reranker-base 模型,下载后默认放在 C:\Users\Administrator\.cache\huggingface\hub 目录,如下图:
重排的代价是延迟(每个候选都要过一遍模型),所以 recall_k 别开太大,20~50 之间比较合理。
 川公网安备51010802032098