切分(Chunking)指把一篇长文档,拆成一段一段短文本(chunk),每一段单独做 embedding、存入 Chroma。它是 RAG 里影响检索效果最核心的环节之一,比向量库 HNSW 参数调优影响更大。也是最容易被忽略的环节,切得不好,再好的模型和索引都白搭。
下图将文档切分为 5 个片段:
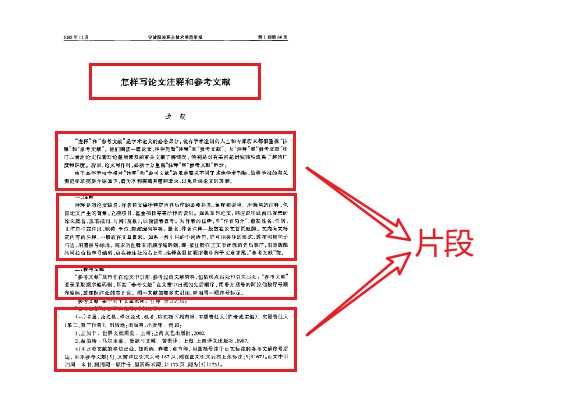
在向集合灌数据时,对每个片段单独做 embedding,然后存入 Chroma。
为什么一定要切分?
Embedding 模型有输入长度上限 比如 BGE 系列一般 512 token,超过长度不能直接向量化;
向量检索是按片段匹配 如果把整篇几千字文档做成一个向量:用户问一个细节,向量相似度会很低,很难命中;
控制上下文密度 chunk 太短:语义不完整,容易断章取义;chunk 太长:里面混杂无关信息,检索召回噪声多,LLM 容易被干扰。
举个例子:你的售后 FAQ 文档,一篇里面同时有退款、发票、物流。不切分,用户只问退款,向量相似度不高,还会把发票、物流内容一起塞给 LLM,况且 LLM 上下文也有长度限制,输入内容越多也越烧 Token。
两个核心参数:chunk_size 、chunk_overlap
chunk_size(块大小,单位 token / 字符)
一块文本最多容纳多少内容。
超过 embedding 模型最大上下文,直接报错。BGE 默认上限 512 token。
chunk_overlap(重叠度,块之间重复的内容)
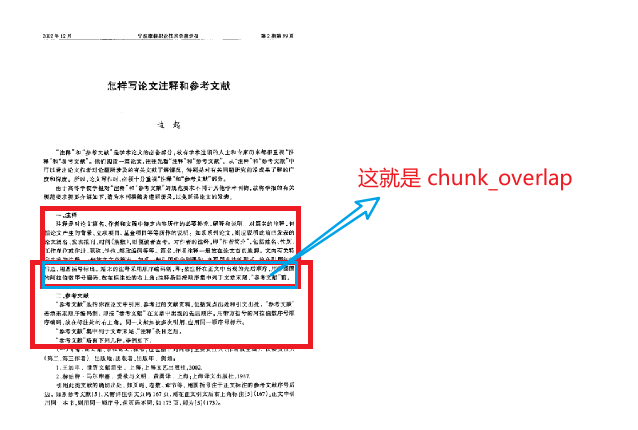
后一个 chunk 和前一个 chunk 保留一部分重复文本。目的:防止一句话、一个知识点被一刀切断,跨两个 chunk,检索的时候两边都召回不到。
常用值:chunk_size 的 10% ~ 20% 例:size=256,overlap=50
chunk1:[0~256] chunk2:[206 ~ 462] (和前面末尾 50 个 token 重叠)
注意,重叠不是越多越好:overlap 太大,重复内容大量入库,浪费 Chroma 存储空间,检索重复片段,增加 LLM 开销。
主流切分算法(从简单到高级)
固定大小切分【最常用,入门首选】
按字符 / 固定 token 长度硬切,到长度就截断。
缺点:很容易把句子、段落、表格、标题从中间劈开,语义断裂。
适合:纯流水文本、日志、简单 FAQ。
递归字符切分
优先按分隔符顺序切:换行 → 段落 → 句号 → 逗号 → 空格
先尝试用换行切;如果切完还是超长,再用句号切;层层递归。
优点:尽量不破坏完整句子,是中文 RAG 默认首选。
语义切分(Semantic Chunking)
不按长度,按语义相似度切:句子之间语义差异大,就断开。
原理:连续句子算向量,相邻向量距离超过阈值,就分割。
优点:语义边界自然,一个知识点单独一块,检索质量上限很高。
缺点:慢,要大量 embedding 计算,消耗算力,成本高。
适合高质量文档,不适合海量文档。
标题感知切分 / Markdown 切分
专门针对 Markdown 文档:按 # 一级标题、## 二级标题 切割,带着标题一起打包进 chunk,非常重要!
比如:
## 退款规则
订单提交后3个工作日到账
出来的 chunk 必须带上标题,不然单独一句 “订单提交后 3 个工作日到账”,LLM 不知道这是退款的规则。 很多 RAG 效果差,就是丢了标题、上下文归属。
结构化切分(PDF / 表格 / HTML)
PDF:按页面、表格、图片说明;
HTML:按标签 <p> <section>;
适合网页、PDF 说明书,需要保留结构。
按句子切分
按句号、问号、感叹号切句子,再把连续句子打包到接近 chunk_size。
切分原则
片段要有完整语义。一句话切成两半,两半都没法用。
片段要有重叠。上一个片段的末尾和下一个片段的开头重叠一点,避免关键信息被切断。
长度要合适。太短丢上下文,太长引入噪音。中文一般 300~800 字比较稳。
一个够用的切分实现
下面自己动手写一个简单的切分实现,主要逻辑如下:
按照指定的分隔符优先级切分,如 ("\n\n", "\n", "。", "!", "?", ";", ",", " "),\n\n 是段落,优先级最高,再按照 \n 是换行,...
切分后,如果片段还是太大,则按照字数硬切分,尽量保证片段的语义完整。
代码如下:
import re
from dataclasses import dataclass


@dataclass
class Chunk:
    text: str
    index: int
    start: int
    end: int


def split_text(
    text: str,
    chunk_size: int = 500,
    overlap: int = 80,
    separators: tuple[str, ...] = ("\n\n", "\n", "。", "!", "?", ";", ",", " "),
) -> list[Chunk]:
    """按段落/句子优先的方式切分,切不开再硬切
    思路:先用大分隔符切(段落),段落太长再退化到下一级(句子),
    最后实在不行按字数切。这样能尽量保证片段的语义完整。
    """
    if chunk_size <= overlap:
        raise ValueError("chunk_size 必须大于 overlap")

    # 递归分隔
    raw = _recursive_split(text, chunk_size, separators)
    print("递归分片:")
    print("=" * 30)
    for idx,p in enumerate(raw):
        print(f"{idx}: {repr(p)}")
    print("=" * 30)

    # 把太短的相邻块合并,避免一堆几十字的碎片
    merged: list[str] = []
    buf = ""
    for piece in raw:
        if not piece.strip():
            continue
        if len(buf) + len(piece) <= chunk_size:
            buf += piece
        else:
            if buf:
                merged.append(buf)
            buf = piece
    if buf:
        merged.append(buf)
    print("\n合并相邻块:")
    print("=" * 30)
    for idx,m in enumerate(merged):
        print(f"{idx}: {repr(m)}")
    print("=" * 30)

    # 加重叠:每个片段往前吞一点上一个片段的尾巴
    chunks: list[Chunk] = []
    pos = 0
    for i, piece in enumerate(merged):
        prefix = ""
        # 提取上一个片段的尾巴
        if i > 0 and overlap > 0:
            prefix = merged[i - 1][-overlap:]
        full = prefix + piece # 拼成完整的片段 = 上一段的尾巴 + 当前片段
        chunks.append(Chunk(text=full, index=i, start=pos, end=pos + len(full)))
        pos += len(piece)

    return chunks


def _recursive_split(text: str, chunk_size: int, separators: tuple[str, ...]) -> list[str]:
    """递归切分"""
    # 如果文本太短,或没有分隔符,直接返回原文本
    if len(text) <= chunk_size or not separators:
        return [text]

    # separators 是按优先级排好的,比如 ("\n\n", "\n", "。", "!", "?", …)。每次只拿最优先的那个 sep 来切
    # 提取第一个分隔符,如 \n\n
    sep = separators[0]  # 优先级最高的分隔符
    rest = separators[1:]
    # 如果 sep 不为空,则使用 sep 分隔文本,否则退化成 list(text) 按字符逐个切开
    # 使用正则表达式切分文本,re.escape() 转义分隔符
    parts = re.split(f"({re.escape(sep)})", text) if sep else list(text)

    # 把分隔符粘回前一个片段
    # 举例:按"。"切 "今天天气好。我们出去玩。"
    # parts ≈ ["今天天气好", "。", "我们出去玩", "。"]
    # buf 累加到 "今天天气好。" 时遇到 p == sep,收口 → piece="今天天气好。"
    # 下一段同理得到 "我们出去玩。"
    pieces: list[str] = []
    buf = ""
    for p in parts:
        buf += p
        if len(buf) >= (chunk_size // 2) or p == sep:
            pieces.append(buf)
            buf = ""
    if buf:
        pieces.append(buf)

    # 分割后,如果某个片段太长,则递归切分
    out: list[str] = []
    for piece in pieces:
        if len(piece) <= chunk_size:
            out.append(piece)
        else:
            # 递归切分
            out.extend(_recursive_split(piece, chunk_size, rest))
    return out


# 试一下
if __name__ == "__main__":
    doc = """
退款政策

一、申请条件
订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

二、申请流程
在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。

三、特殊情况
如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。
"""

    for c in split_text(doc, chunk_size=200, overlap=30):
        print(f"\n--- chunk {c.index} ({len(c.text)} 字) ---")
        print(c.text)
运行示例代码,输出如下:
递归分片:
==============================
0: '\n退款政策\n\n'
1: '一、申请条件\n订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。\n定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。\n\n'
2: '二、申请流程\n在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。\n客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。\n\n'
3: '三、特殊情况\n如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。\n'
==============================

合并相邻块:
==============================
0: '\n退款政策\n\n一、申请条件\n订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。\n定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。\n\n二、申请流程\n在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。\n客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。\n\n'
1: '三、特殊情况\n如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。\n'
==============================

--- chunk 0 (164 字) ---

退款政策

一、申请条件
订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

二、申请流程
在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。


--- chunk 1 (74 字) ---
核,审核通过后退款将在 3-5 个工作日退回原支付账户。

三、特殊情况
如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。
分析输出,递归分片时,直接使用“\n\n”分完片,共四片。但是,每片的内容太少,有进行了合并操作,最终两片。最后,进行重叠,让第二片的前面重叠一部分第一片的末尾内容。
带标题的切分(很实用)
文档的小标题往往携带关键信息,但切分后片段里可能没有标题,导致检索时丢失上下文。解决办法是把标题拼到每个片段前面:
# 注意,复用前面开发的 split_text()、_recursive_split() 和 Chunk

def split_markdown(md: str, chunk_size=500, overlap=80) -> list[tuple[str, str]]:
    """按 markdown 标题切,返回 [(带标题的文本, 标题), ...]"""
    # 匹配标题,\n 换行符后必须是 1~6 个 # 字符,紧接着是空格
    blocks = re.split(r"\n(?=#{1,6} )", md)
    out = []
    for block in blocks:
        lines = block.strip().split("\n")
        # 如果 lines 存在,且第一个元素以 # 开头,则将左侧的 # 和空格去掉,否则 title 为空
        title = lines[0].lstrip("# ").strip() if lines and lines[0].startswith("#") else ""
        # 如果存在标题,则将标题剔除,否则保留所有行
        body = "\n".join(lines[1:] if title else lines)
        # 对 body 进行切分,body下面的切分片段手动添加标题
        for c in split_text(body, chunk_size=chunk_size, overlap=overlap):
            text = f"【{title}】\n{c.text}" if title else c.text
            out.append((text, title))
    return out

# 测试验证,仅直接运行该文件才执行
if __name__ == "__main__":
    doc = """
# 退款政策

一、申请条件
订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

二、申请流程
在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。

三、特殊情况
如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。
"""

    for c in split_markdown(doc, chunk_size=200, overlap=30):
        print(f"\n--- chunk ({len(c[0])} 字) {c[1]} ---")
        print(c[0])
运行代码,输出结果如下:
--- chunk (165 字) 退款政策 ---
【退款政策】

一、申请条件
订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

二、申请流程
在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。


--- chunk (80 字) 退款政策 ---
【退款政策】
核,审核通过后退款将在 3-5 个工作日退回原支付账户。

三、特殊情况
如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。
这样每个片段都自带章节信息,检索的时候命中率会高一截。
 川公网安备51010802032098