前面虽然已经将“搭一个 RAG 检索服务”需要的工具都准备好了,但它们都是零散的,还不能一起工作。下面将创建一个 RAGService 类,将前面提供的工具整合起来,提供一个完整的、可以运行的 RAG 检索服务。
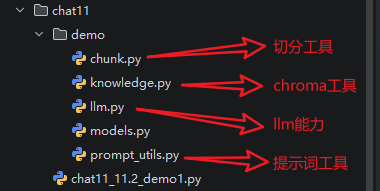
注意,我已近将上面提供的工具按文件放在当前目录下的 demo 目录下面,后续直接 import 导入使用即可,如下图:
代码如下:
import os
import tempfile

from chromadb.utils.embedding_functions import OllamaEmbeddingFunction
from demo.prompt_utils import build_prompt
from demo.knowledge import KnowledgeBase
from demo.models import KBConfig
from demo.chunk import split_markdown
from demo.llm import OpenAILLM

# 持久化示例写到临时目录,工作目录保持干净
os.chdir(tempfile.mkdtemp(prefix="chroma_demo_"))


class RAGService:
    """知识库问答服务"""
    def __init__(self, kb: KnowledgeBase, llm, top_k: int = 5,
                 min_similarity: float | None = None):
        self.kb = kb
        self.llm = llm
        self.top_k = top_k
        self.min_similarity = min_similarity

    def answer(self, question: str, where: dict | None = None) -> dict:
        chunks = self.kb.search(question, top_k=self.top_k, where=where)

        # 相似度过滤:低于阈值的不喂给模型,省得它瞎编
        if self.min_similarity is not None:
            chunks = [c for c in chunks
                      if c.similarity is None or c.similarity >= self.min_similarity]

        if not chunks:
            return {
                "answer": "资料中没有提到相关内容。",
                "sources": [],
                "has_context": False,
            }

        # 构建提示词
        prompt = build_prompt(question, chunks)
        print(f"prompt:")
        print("=" * 40)
        print(prompt)
        print("=" * 40)

        # LLM对话
        answer = self.llm.complete(prompt)

        return {
            "answer": answer,
            "sources": [
                {"id": c.id, "doc_id": c.metadata.get("doc_id"),
                 "similarity": round(c.similarity, 4) if c.similarity else None,
                 "text": c.text[:200]}
                for c in chunks
            ],
            "has_context": True,
        }

if __name__ == "__main__":
    # 真实环境,用 Ollama 的 bge-m3 模型(先在 ollama 里 pull 并启动服务)
    ef = OllamaEmbeddingFunction(
        url="http://localhost:11434",
        model_name="bge-m3",
        timeout=60,
    )
    def my_embedding_func(texts: list[str]) -> list[list[float]]:
        return ef(texts)

    # 1) 建知识库:注入配置和嵌入器
    kb = KnowledgeBase(config=KBConfig(), embedder=my_embedding_func)

    # 2) 建服务:接本地 Ollama(qwen3:4b),并做相似度过滤
    # 使用 AiCore API 代理,注册地址 https://api.xty.app/register?aff=pO2q,有免费额度
    llm = OpenAILLM(base_url="https://api.xty.app/v1", model="qwen-max")
    rag = RAGService(kb, llm, top_k=3, min_similarity=0.05)

    # 3) 导入一份文档(按 markdown 标题切分)
    doc = """
    # 退款政策

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。

    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。
    """
    chunks = [t for t, _ in split_markdown(doc, chunk_size=150, overlap=30)]
    n = kb.add_document("refund_policy", chunks, meta={"category": "售后", "year": 2026})
    print(f"导入 {n} 个片段,库里共 {kb.count()} 条")

    # 4) 问答
    for q in ["买的东西不想要了,钱能退回来吗", "发票怎么开"]:
        r = rag.answer(q)
        print(f"问题:{q}")
        print(f"回答:{r['answer']}")
        print("来源:")
        for idx, c in enumerate(r["sources"], 1):
            print(f"[{c["id"]}] sim={c["similarity"]} => {c["text"]}")
        print("\n\n")
直接运行上面脚本,输出效果如下:
导入 3 个片段,库里共 3 条
prompt:
========================================
你是一个客服助手。请只根据下面提供的资料回答用户的问题。
如果资料里没有相关信息,就明确说"资料中没有提到",不要编造。
回答时请注明你参考了哪条资料(用 [id] 标注)。

资料:
[refund_policy#1] 【退款政策】
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。

[refund_policy#0] 【退款政策】

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。

[refund_policy#2] 【退款政策】
内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。


用户问题:买的东西不想要了,钱能退回来吗

回答:
========================================
问题:买的东西不想要了,钱能退回来吗
回答:根据您的情况,如果购买的商品不是定制类商品、已拆封的音像制品或虚拟商品,并且在签收后的7天内未影响二次销售的话,是可以申请无理由退货的。您可以在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。客服会在24小时内审核,审核通过后,退款将在3-5个工作日内退回至您的原支付账户。[refund_policy#0][refund_policy#1]
来源:
[refund_policy#1] sim=0.7277 => 【退款政策】
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。
[refund_policy#0] sim=0.7183 => 【退款政策】

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。
[refund_policy#2] sim=0.6728 => 【退款政策】
内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。


prompt:
========================================
你是一个客服助手。请只根据下面提供的资料回答用户的问题。
如果资料里没有相关信息,就明确说"资料中没有提到",不要编造。
回答时请注明你参考了哪条资料(用 [id] 标注)。

资料:
[refund_policy#2] 【退款政策】
内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。

[refund_policy#1] 【退款政策】
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。

[refund_policy#0] 【退款政策】

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。


用户问题:发票怎么开

回答:
========================================
问题:发票怎么开
回答:您可以在"个人中心-发票管理"里自助开具电子发票,开票后24小时内会发送到您的预留邮箱。[refund_policy#2]
来源:
[refund_policy#2] sim=0.5566 => 【退款政策】
内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。    ## 三、特殊情况
    如果商品存在质量问题,不受 7 天限制,可以随时申请,且运费由我们承担。

    ## 四、发票
    电子发票可以在"个人中心-发票管理"里自助开具,开票后 24 小时内发送到预留邮箱。
[refund_policy#1] sim=0.46 => 【退款政策】
定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。    ## 二、申请流程
    在"我的订单"页面找到对应订单,点击"申请退款",填写原因并提交。
    客服会在 24 小时内审核,审核通过后退款将在 3-5 个工作日退回原支付账户。
[refund_policy#0] sim=0.4485 => 【退款政策】

    ## 一、申请条件
    订单在签收后 7 天内,且商品未影响二次销售的,可以申请无理由退货。
    定制类商品、已拆封的音像制品、虚拟商品不在无理由退货范围内。
从上面输出结果得到的几个观察:
文档被切分为 3 个独立 chunk,标记 refund_policy#0/#1/#2。
召回策略:固定召回 Top3,不做过滤,只要分数达到阈值就全部拿进来,无关内容会一并召回。 例:查询「发票怎么开」,退款条件、退款流程的 chunk 也被召回,只是相似度更低。这就是 min_similarity 和重排存在的意义。
相似度打分:语义相似度只衡量 chunk 整体和 query 的相关性,chunk 内部可能同时包含相关 + 无关内容。发票这个 query,相关内容只占 chunk#[refund_policy#2] 很小一部分,所以 sim 值偏低。
关于 min_similarity
上面我把阈值设成了 0.05,基本等于不过滤。真实场景这个值要在你的数据上测出来 —— 跑一批标注样本,看“相关”和“不相关”的相似度分布,找分界线。用 bge + cosine 的话,我见过的经验区间是 0.3~0.5,但不同模型和不同语料差别很大,别抄这个数,自己去测试,找出适合你自己的值。
 川公网安备51010802032098